大家好,我是老鹿。针对 MiniMax H3 视频生成整合包,我做了优化和更新。
新版本修复了老版本的一些已知问题,提升了提示词优化功能的推理速度,新增 Sol-Attn 加速,视频生成速度更快;同时支持生成超过 15 秒的长视频,并新增提示词特效 token。
制作周期较长,敬请谅解。制作不易,恳请各位鹿友一键三连。
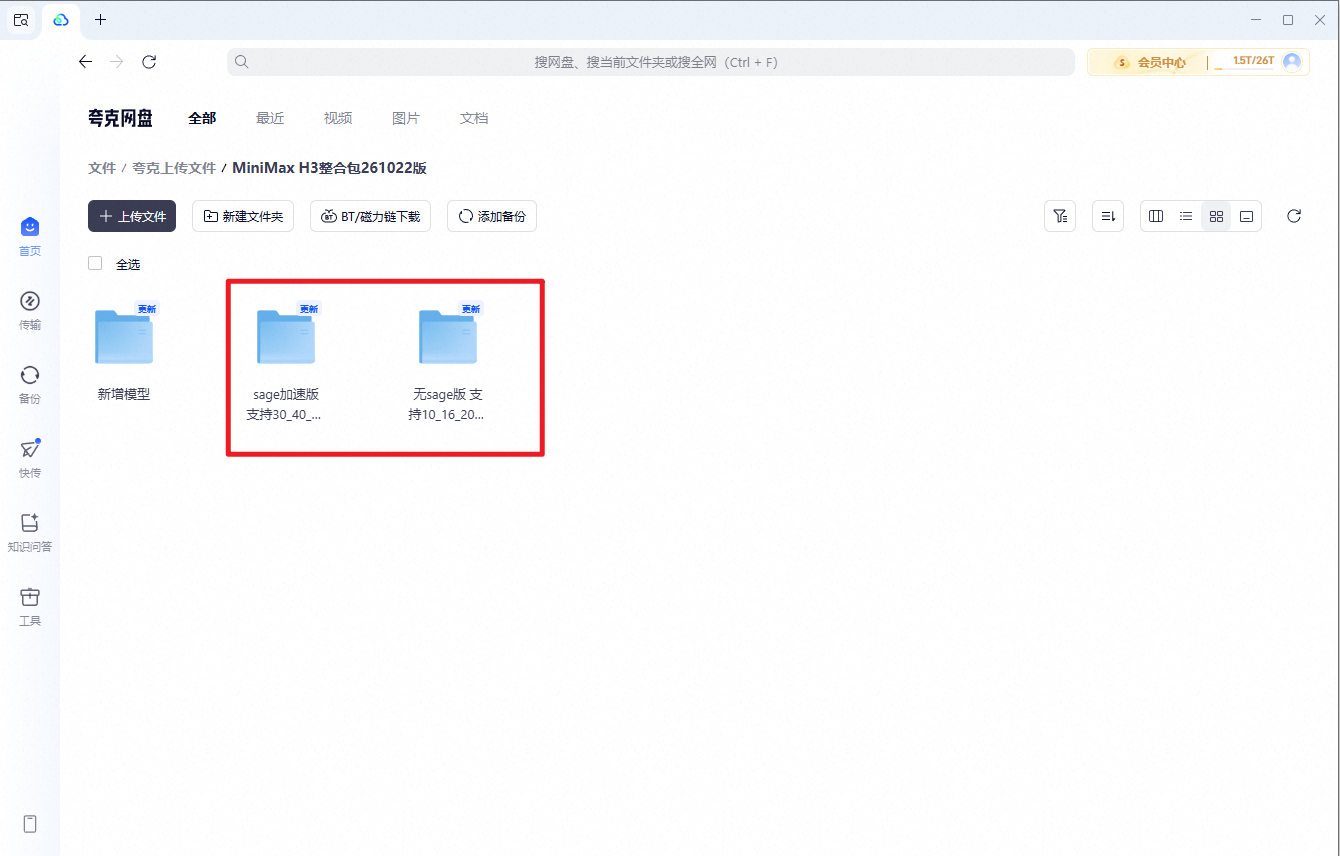
本次更新整合包同样分为 Sage 加速版和无 Sage 版:Sage 加速版支持 30、40、50 系显卡,无 Sage 版支持 10、16、20 系显卡。
需要提醒的是,本次更新的加速功能仅对支持 Sage 加速的显卡有效。如果你不清楚自己的显卡该下载哪个版本,直接把显卡型号发给 AI,询问是否支持 Sage 加速即可。
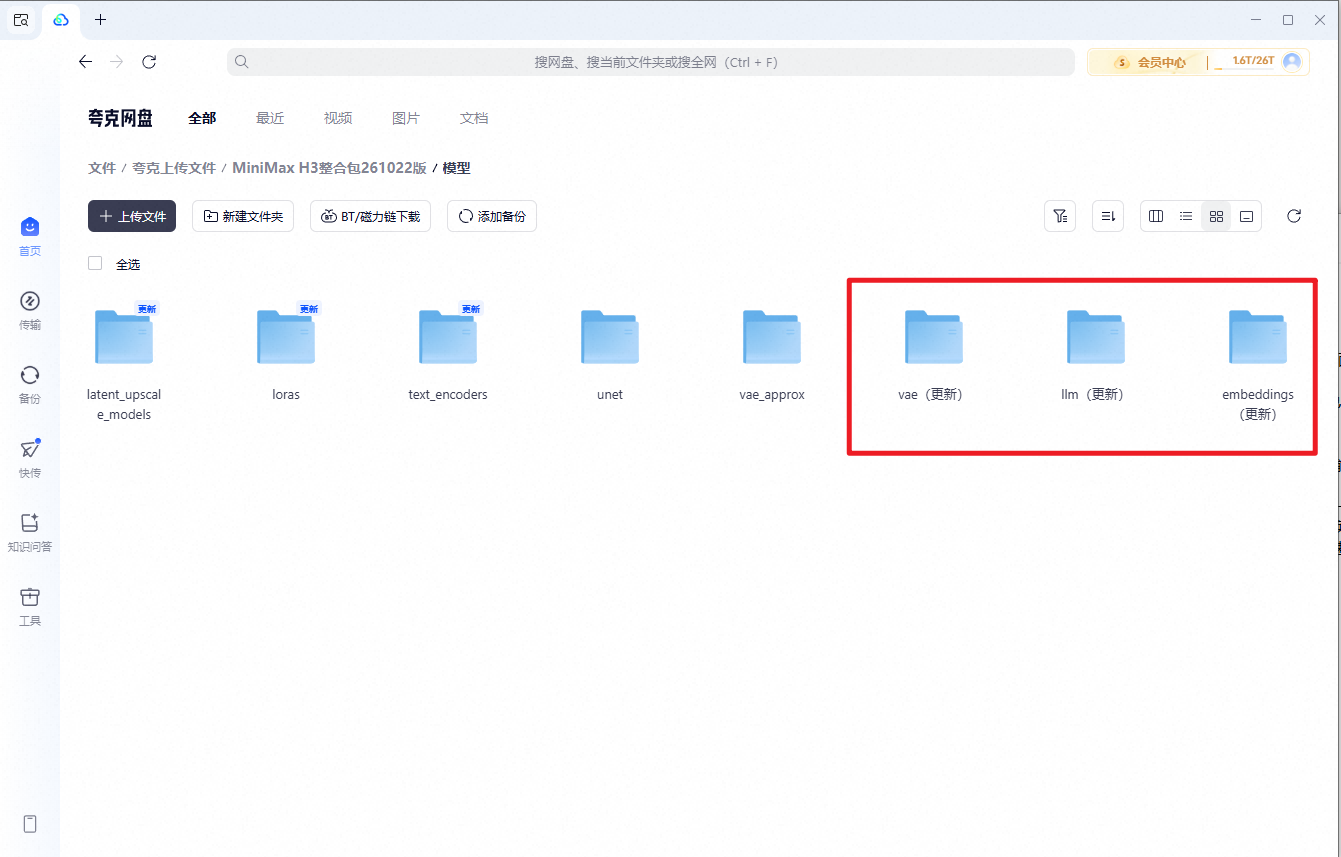
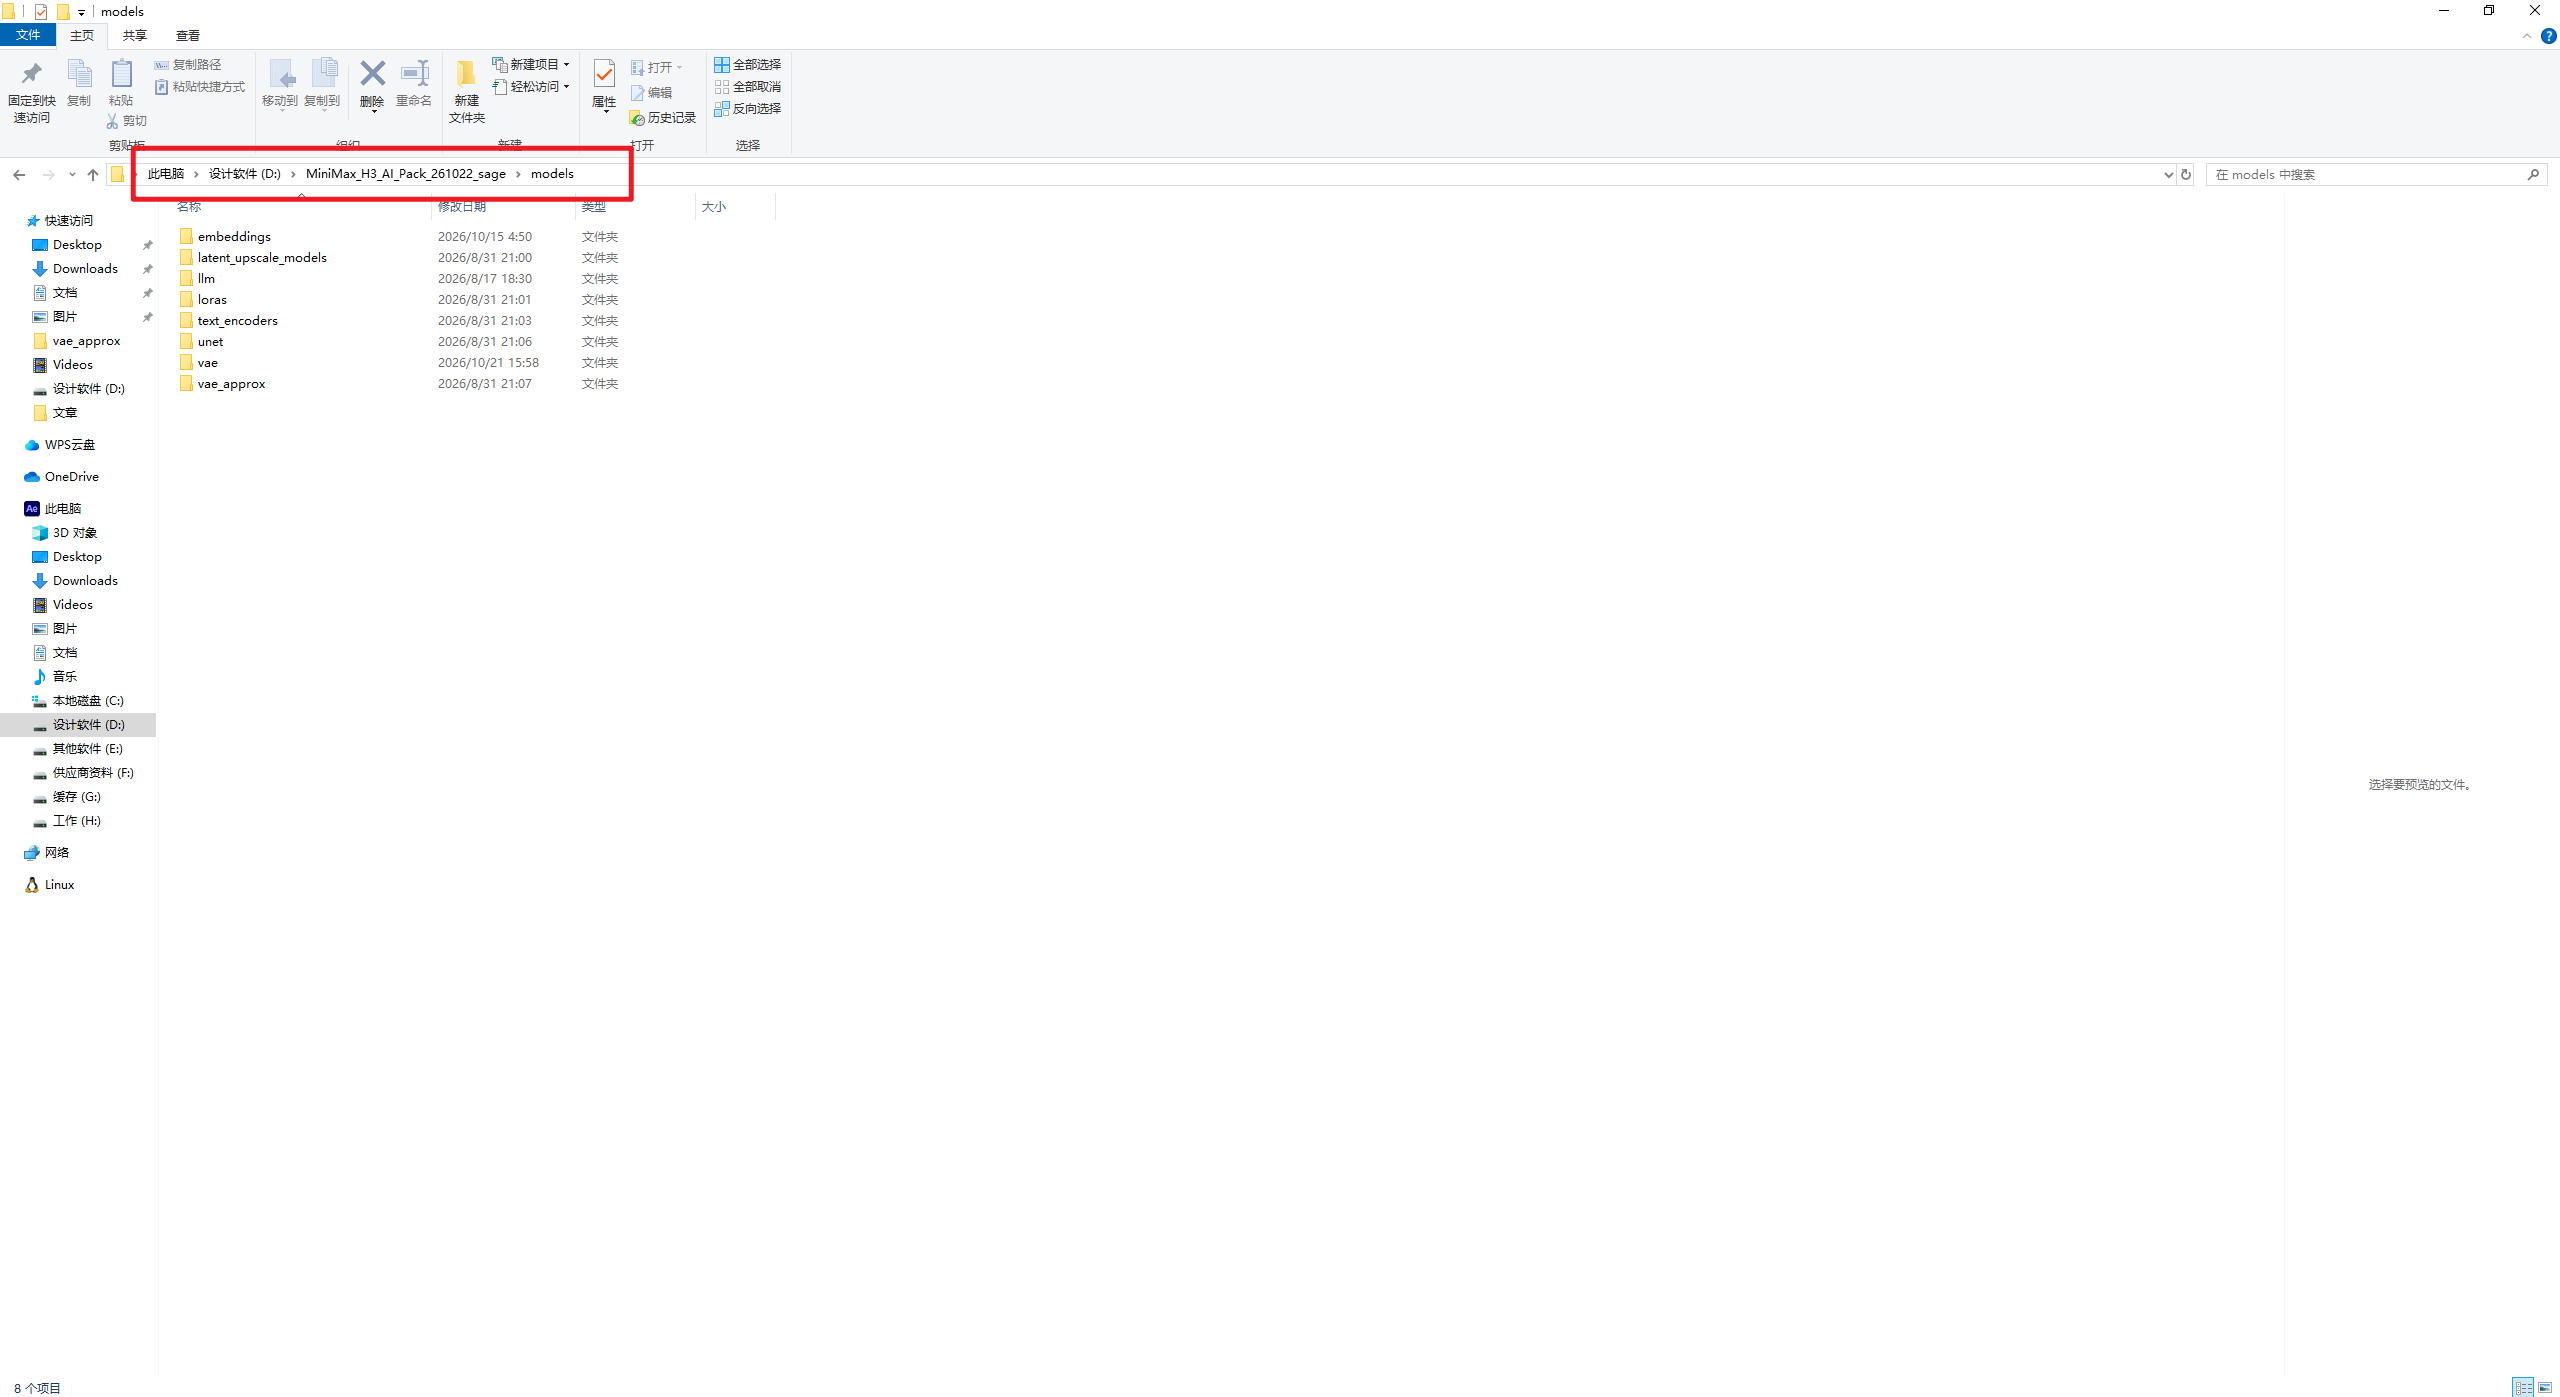
模型方面,本次更新的内容我已为大家标注好:新增了 Embeddings 模型,并更新了 VAE 和 LMM 模型。
如果你使用过旧版本整合包,只需下载这三个新模型进行新增和替换即可;不要忘记删除文件夹名中的中文。
下载好的模型仍放入整合包根目录的 models 文件夹中。再次提醒,整合包路径不要包含中文。
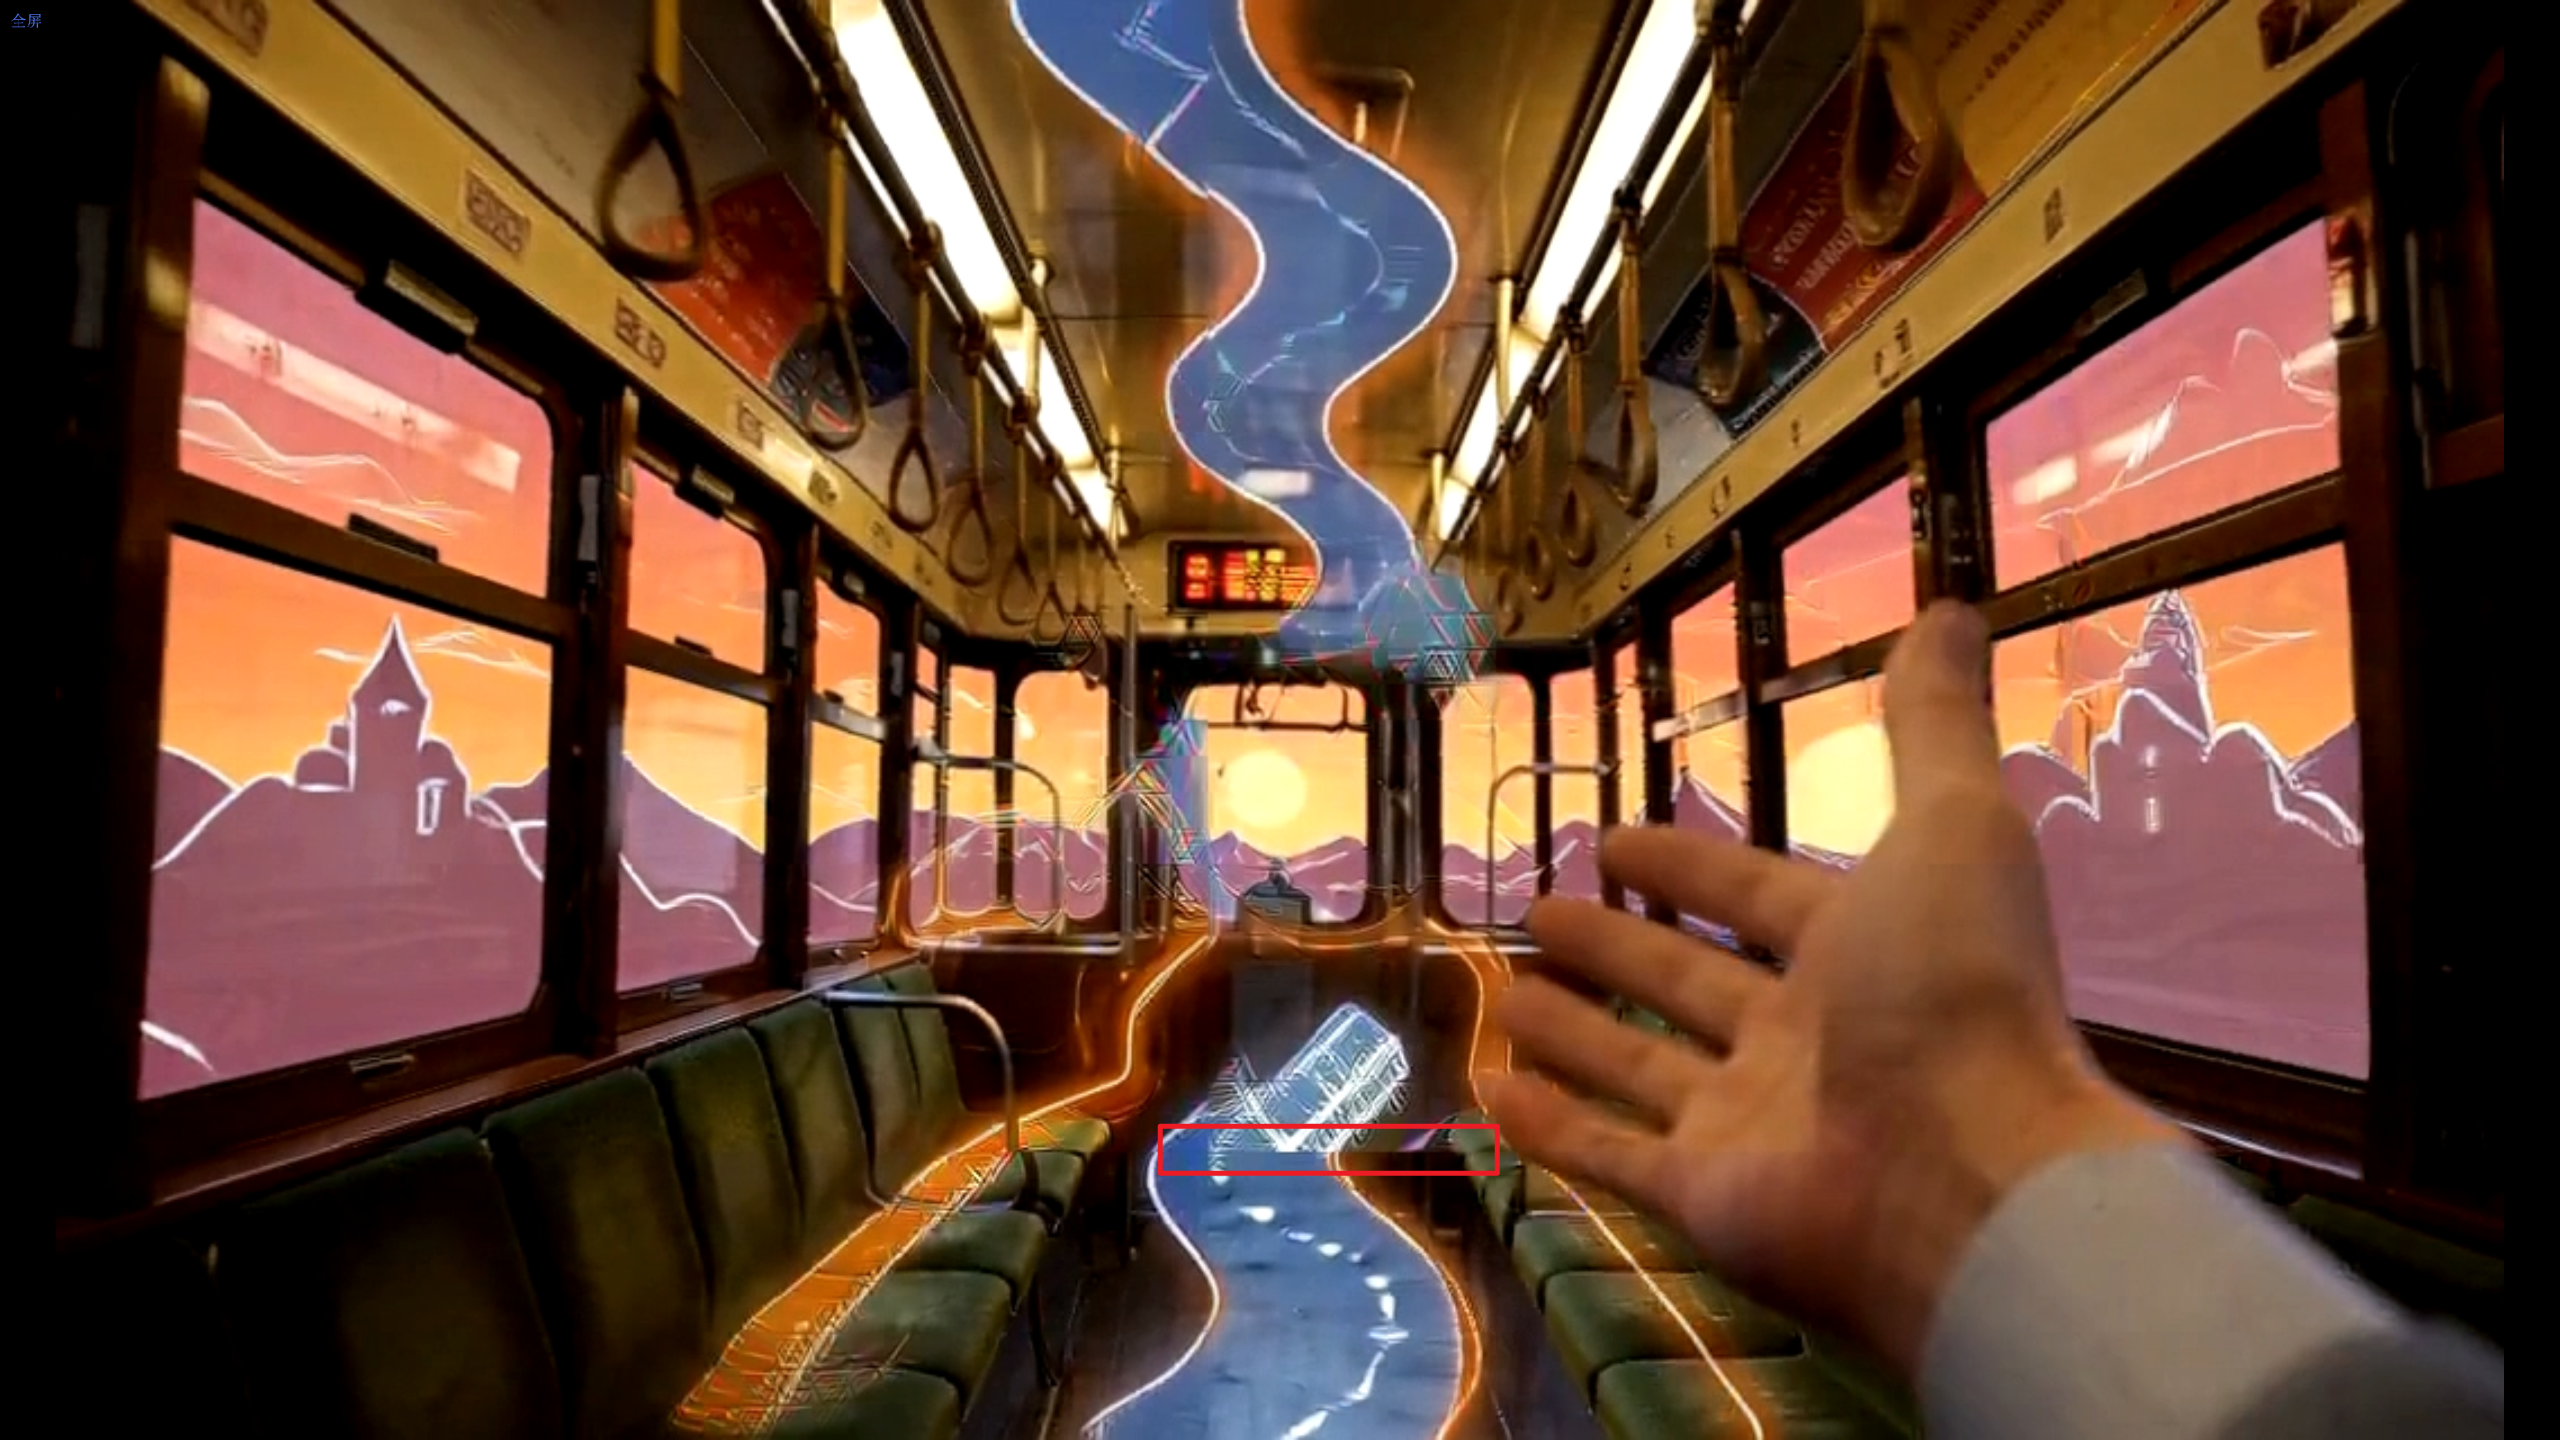
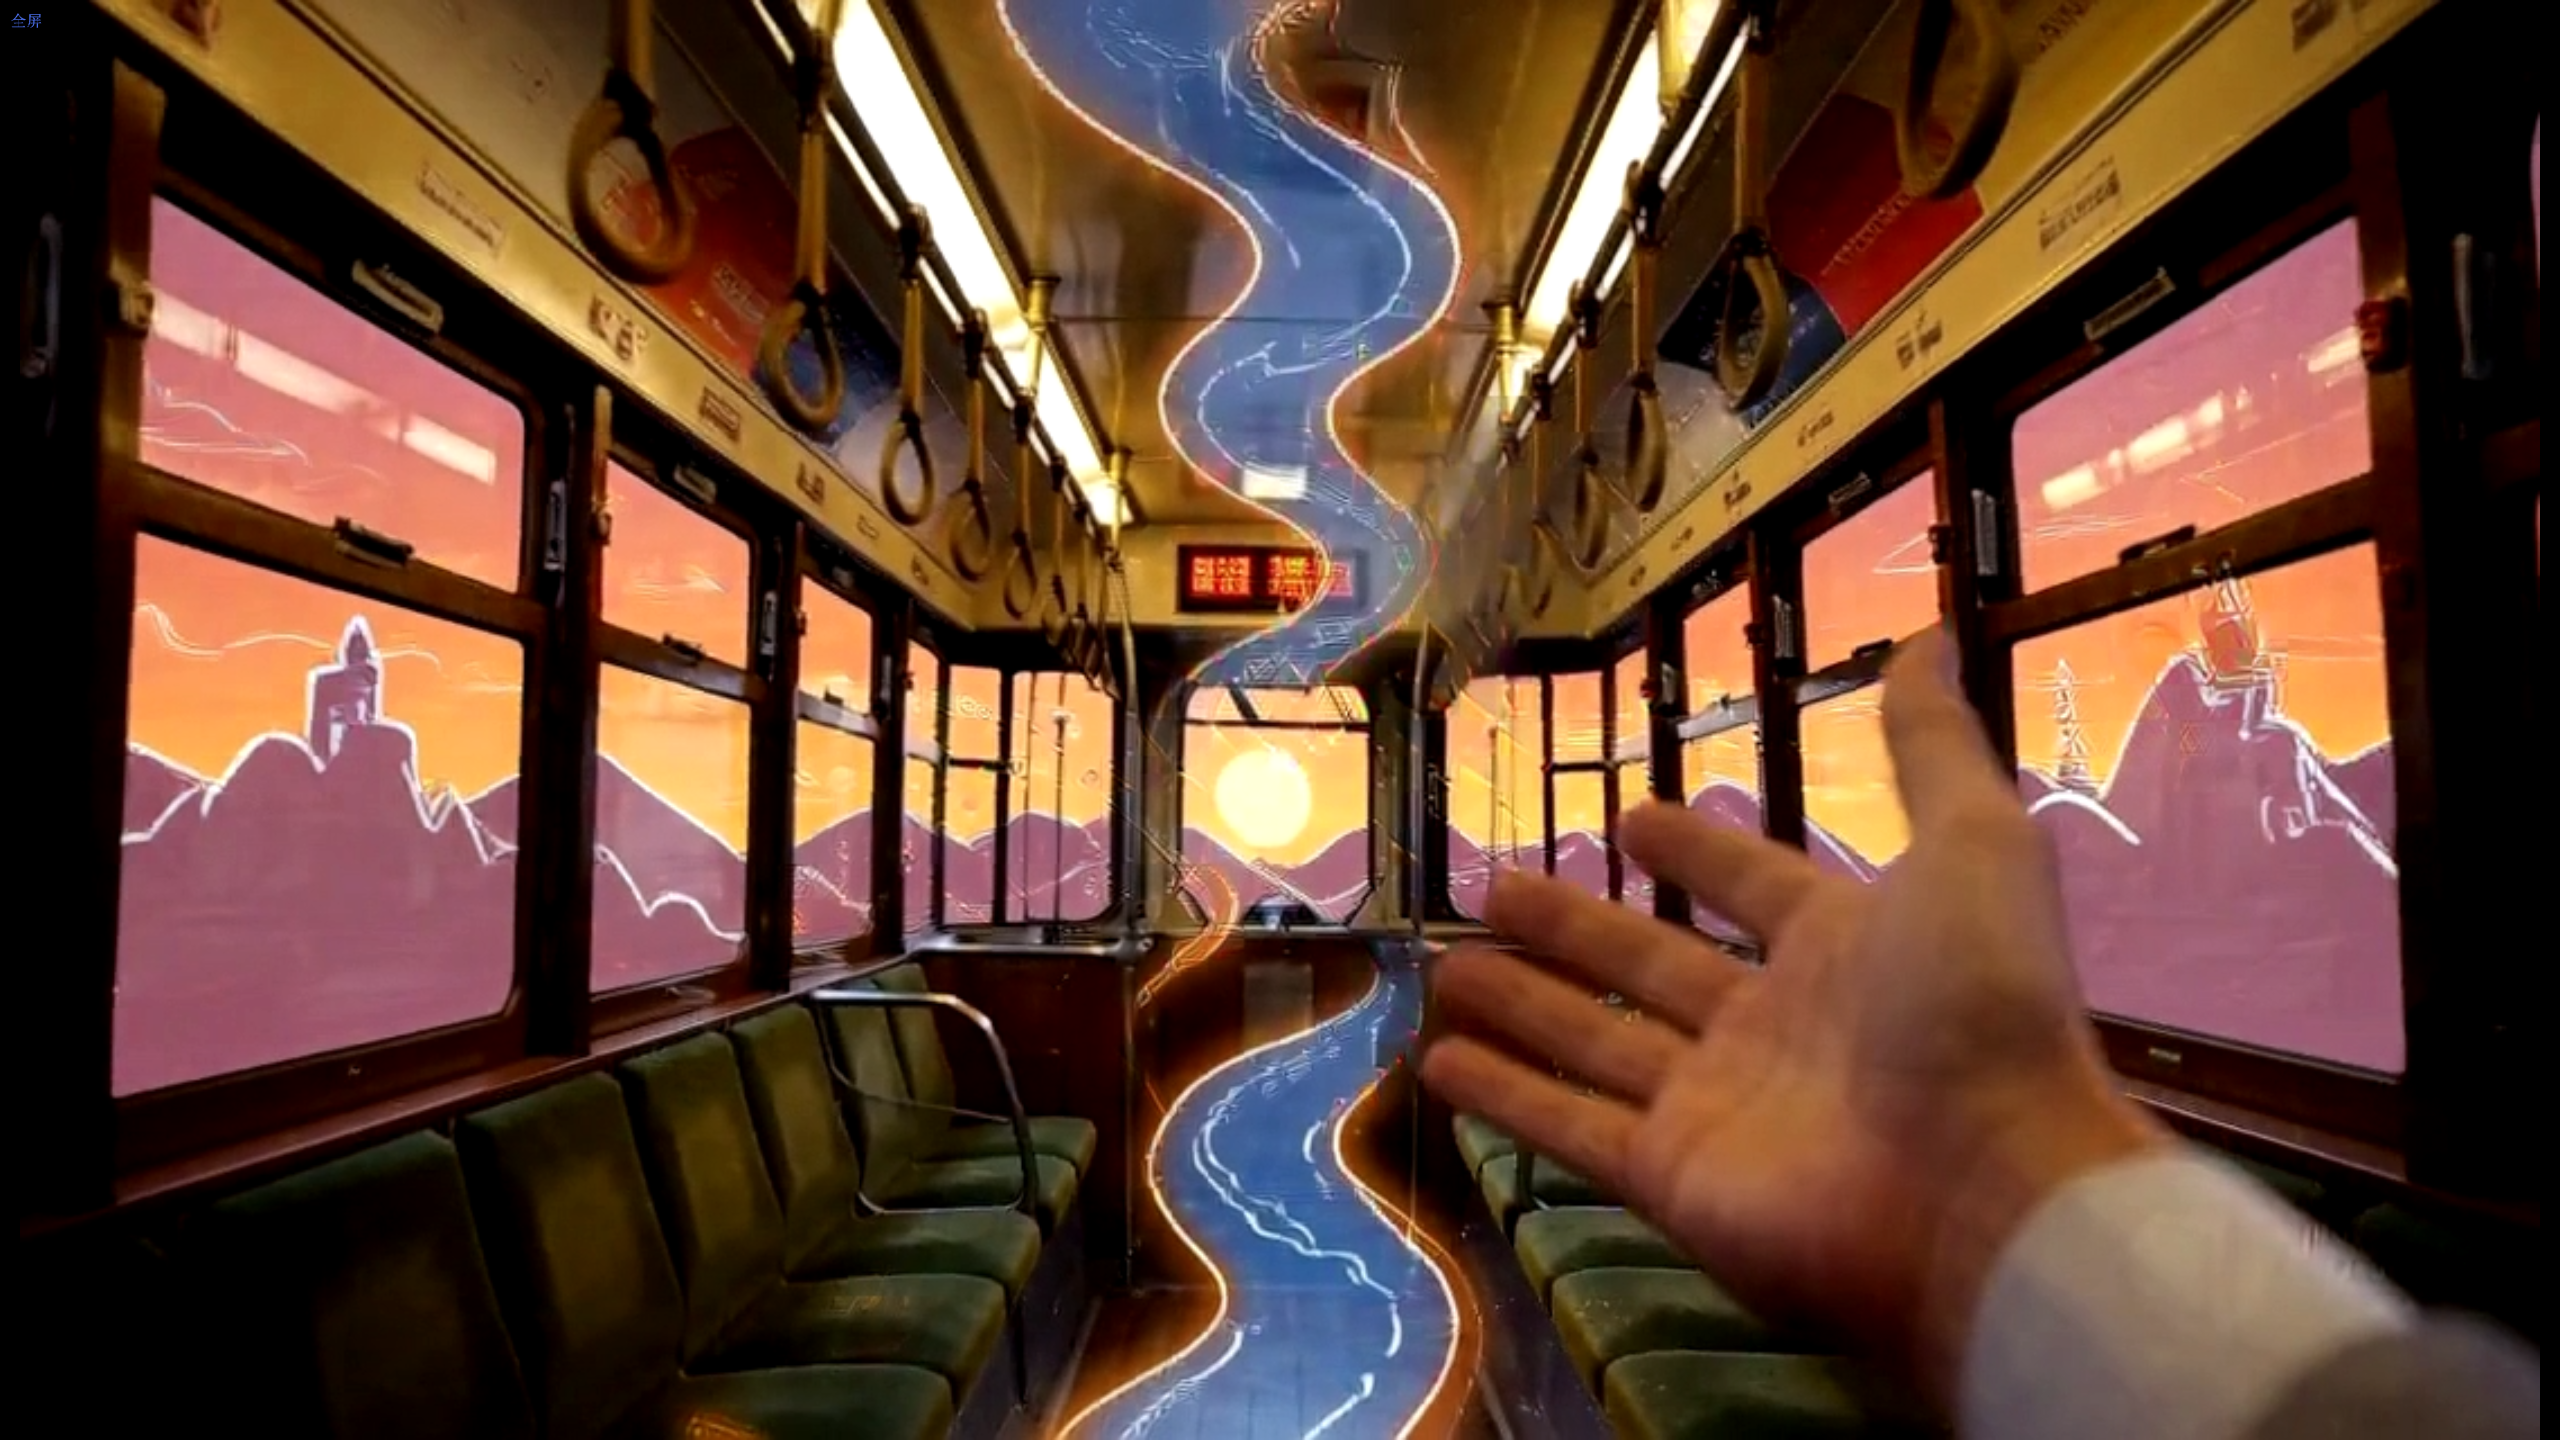
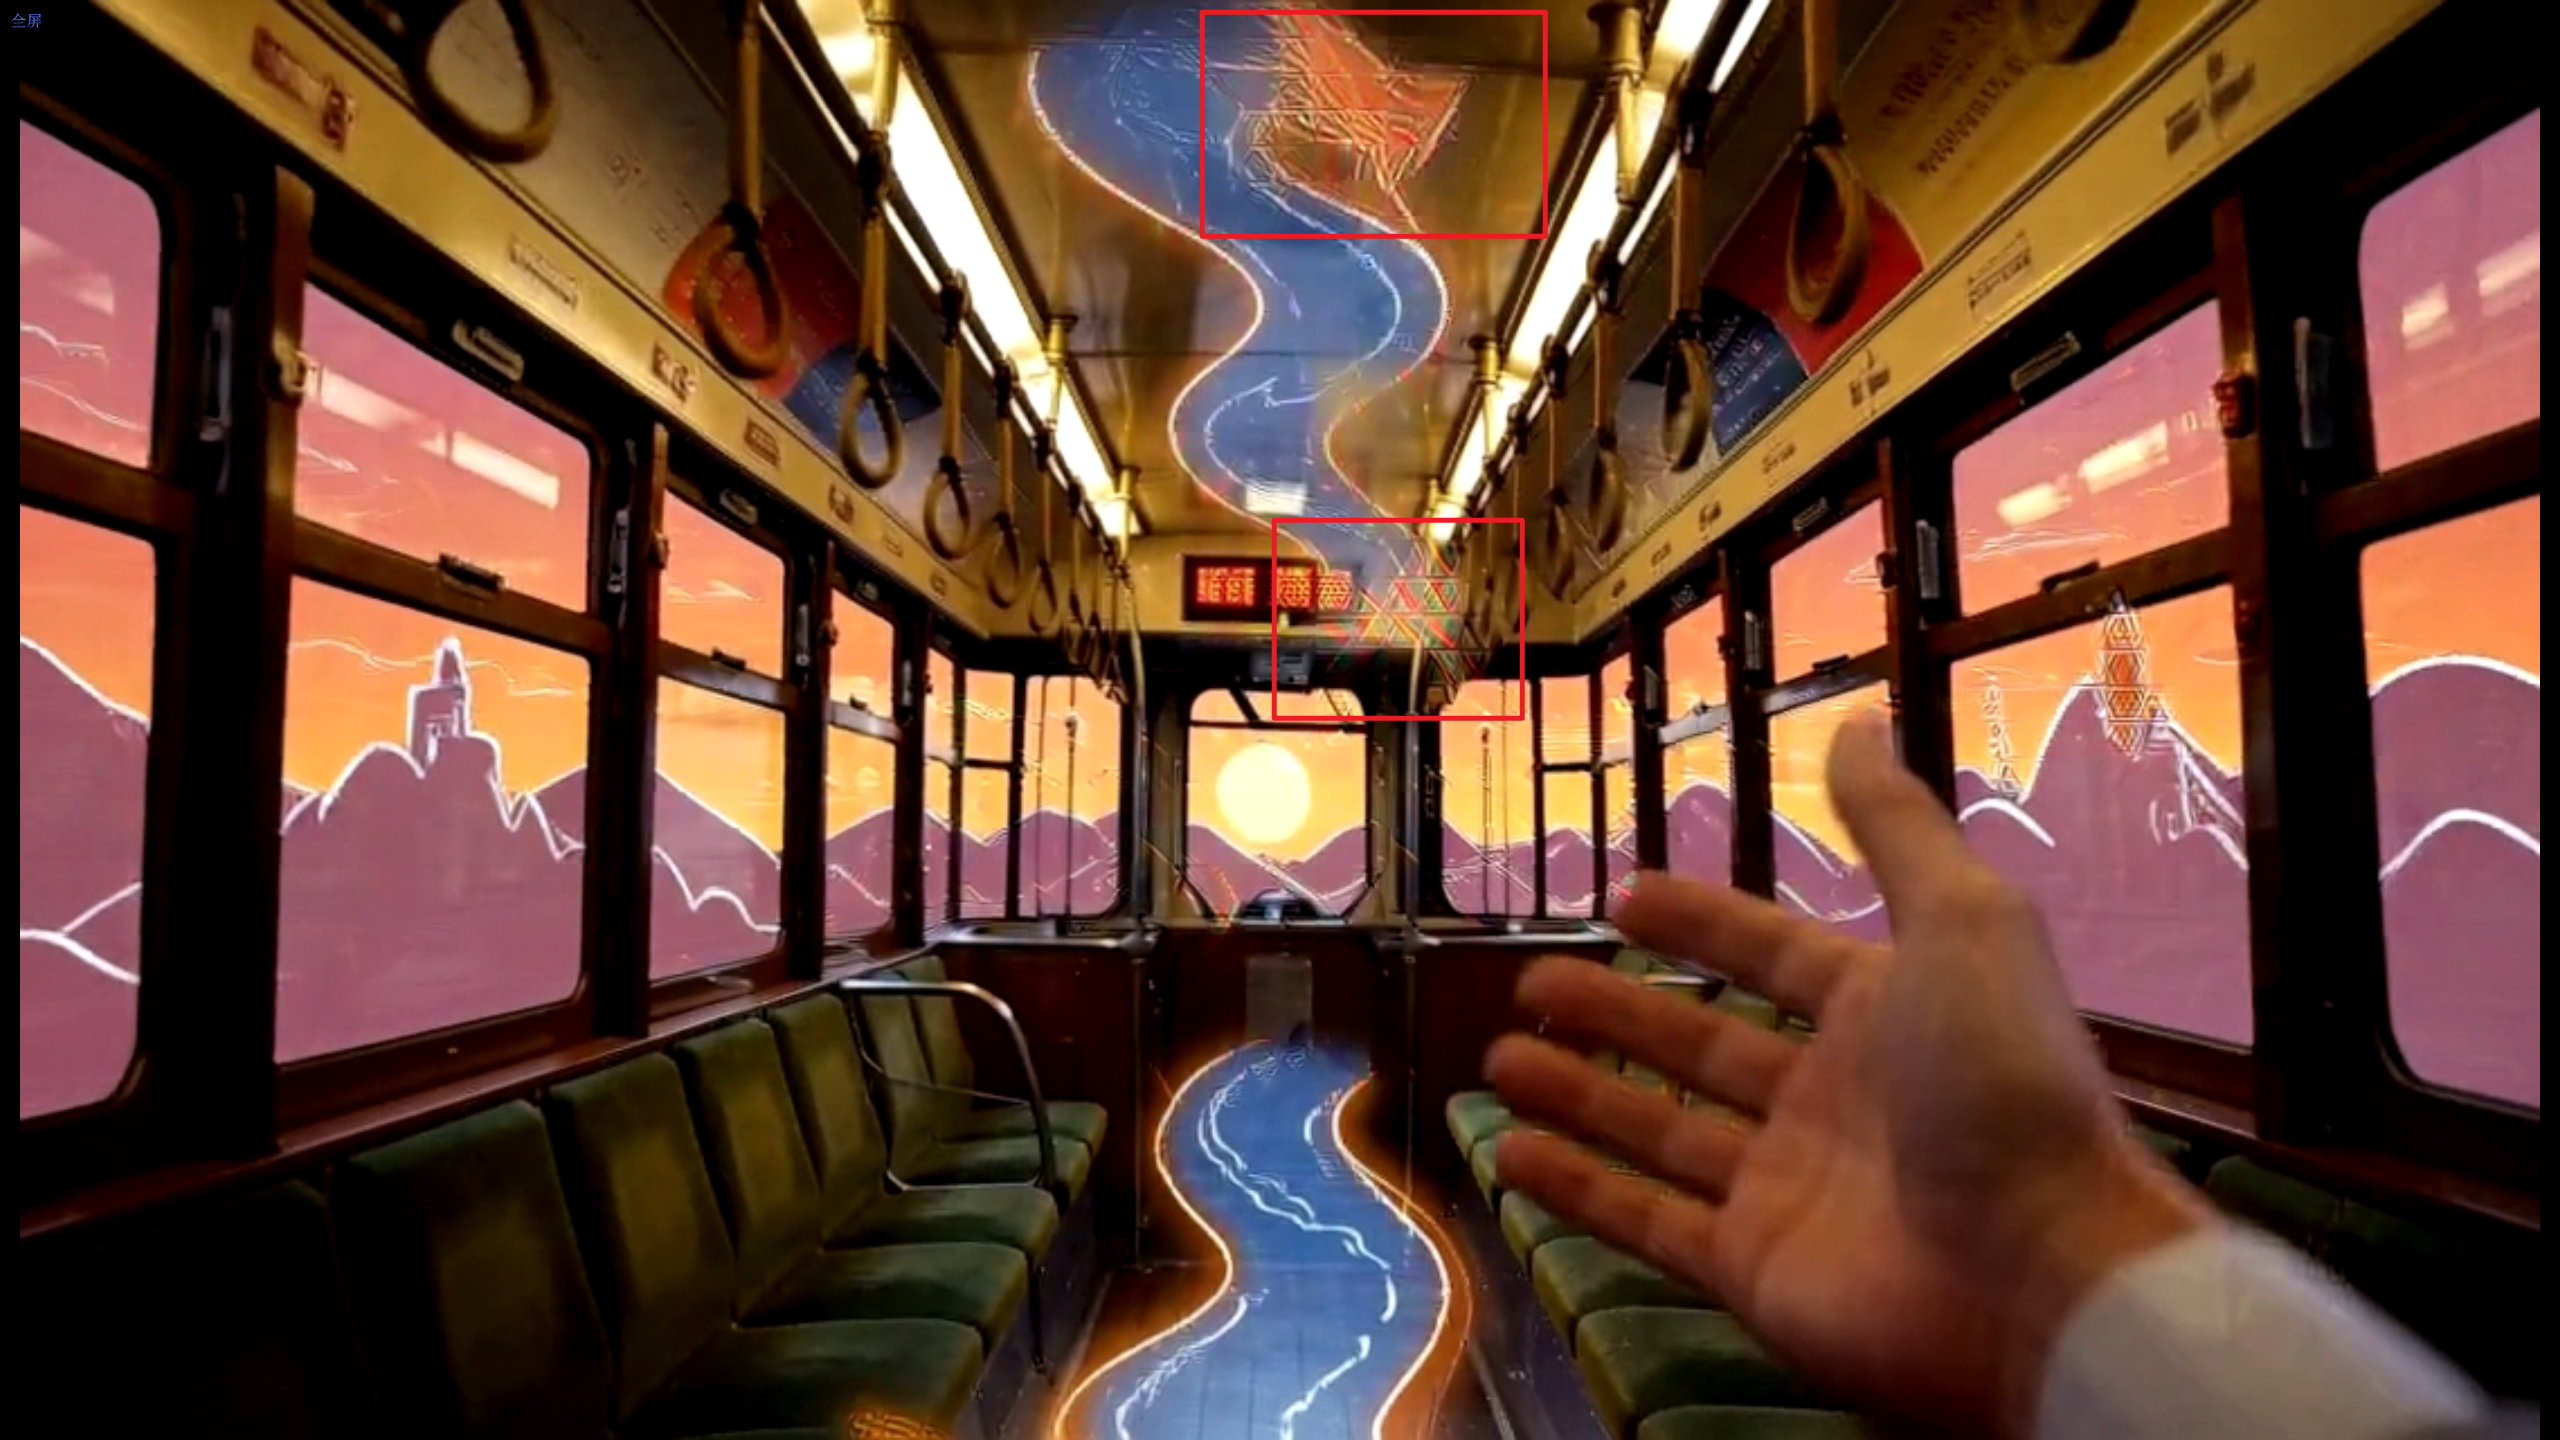
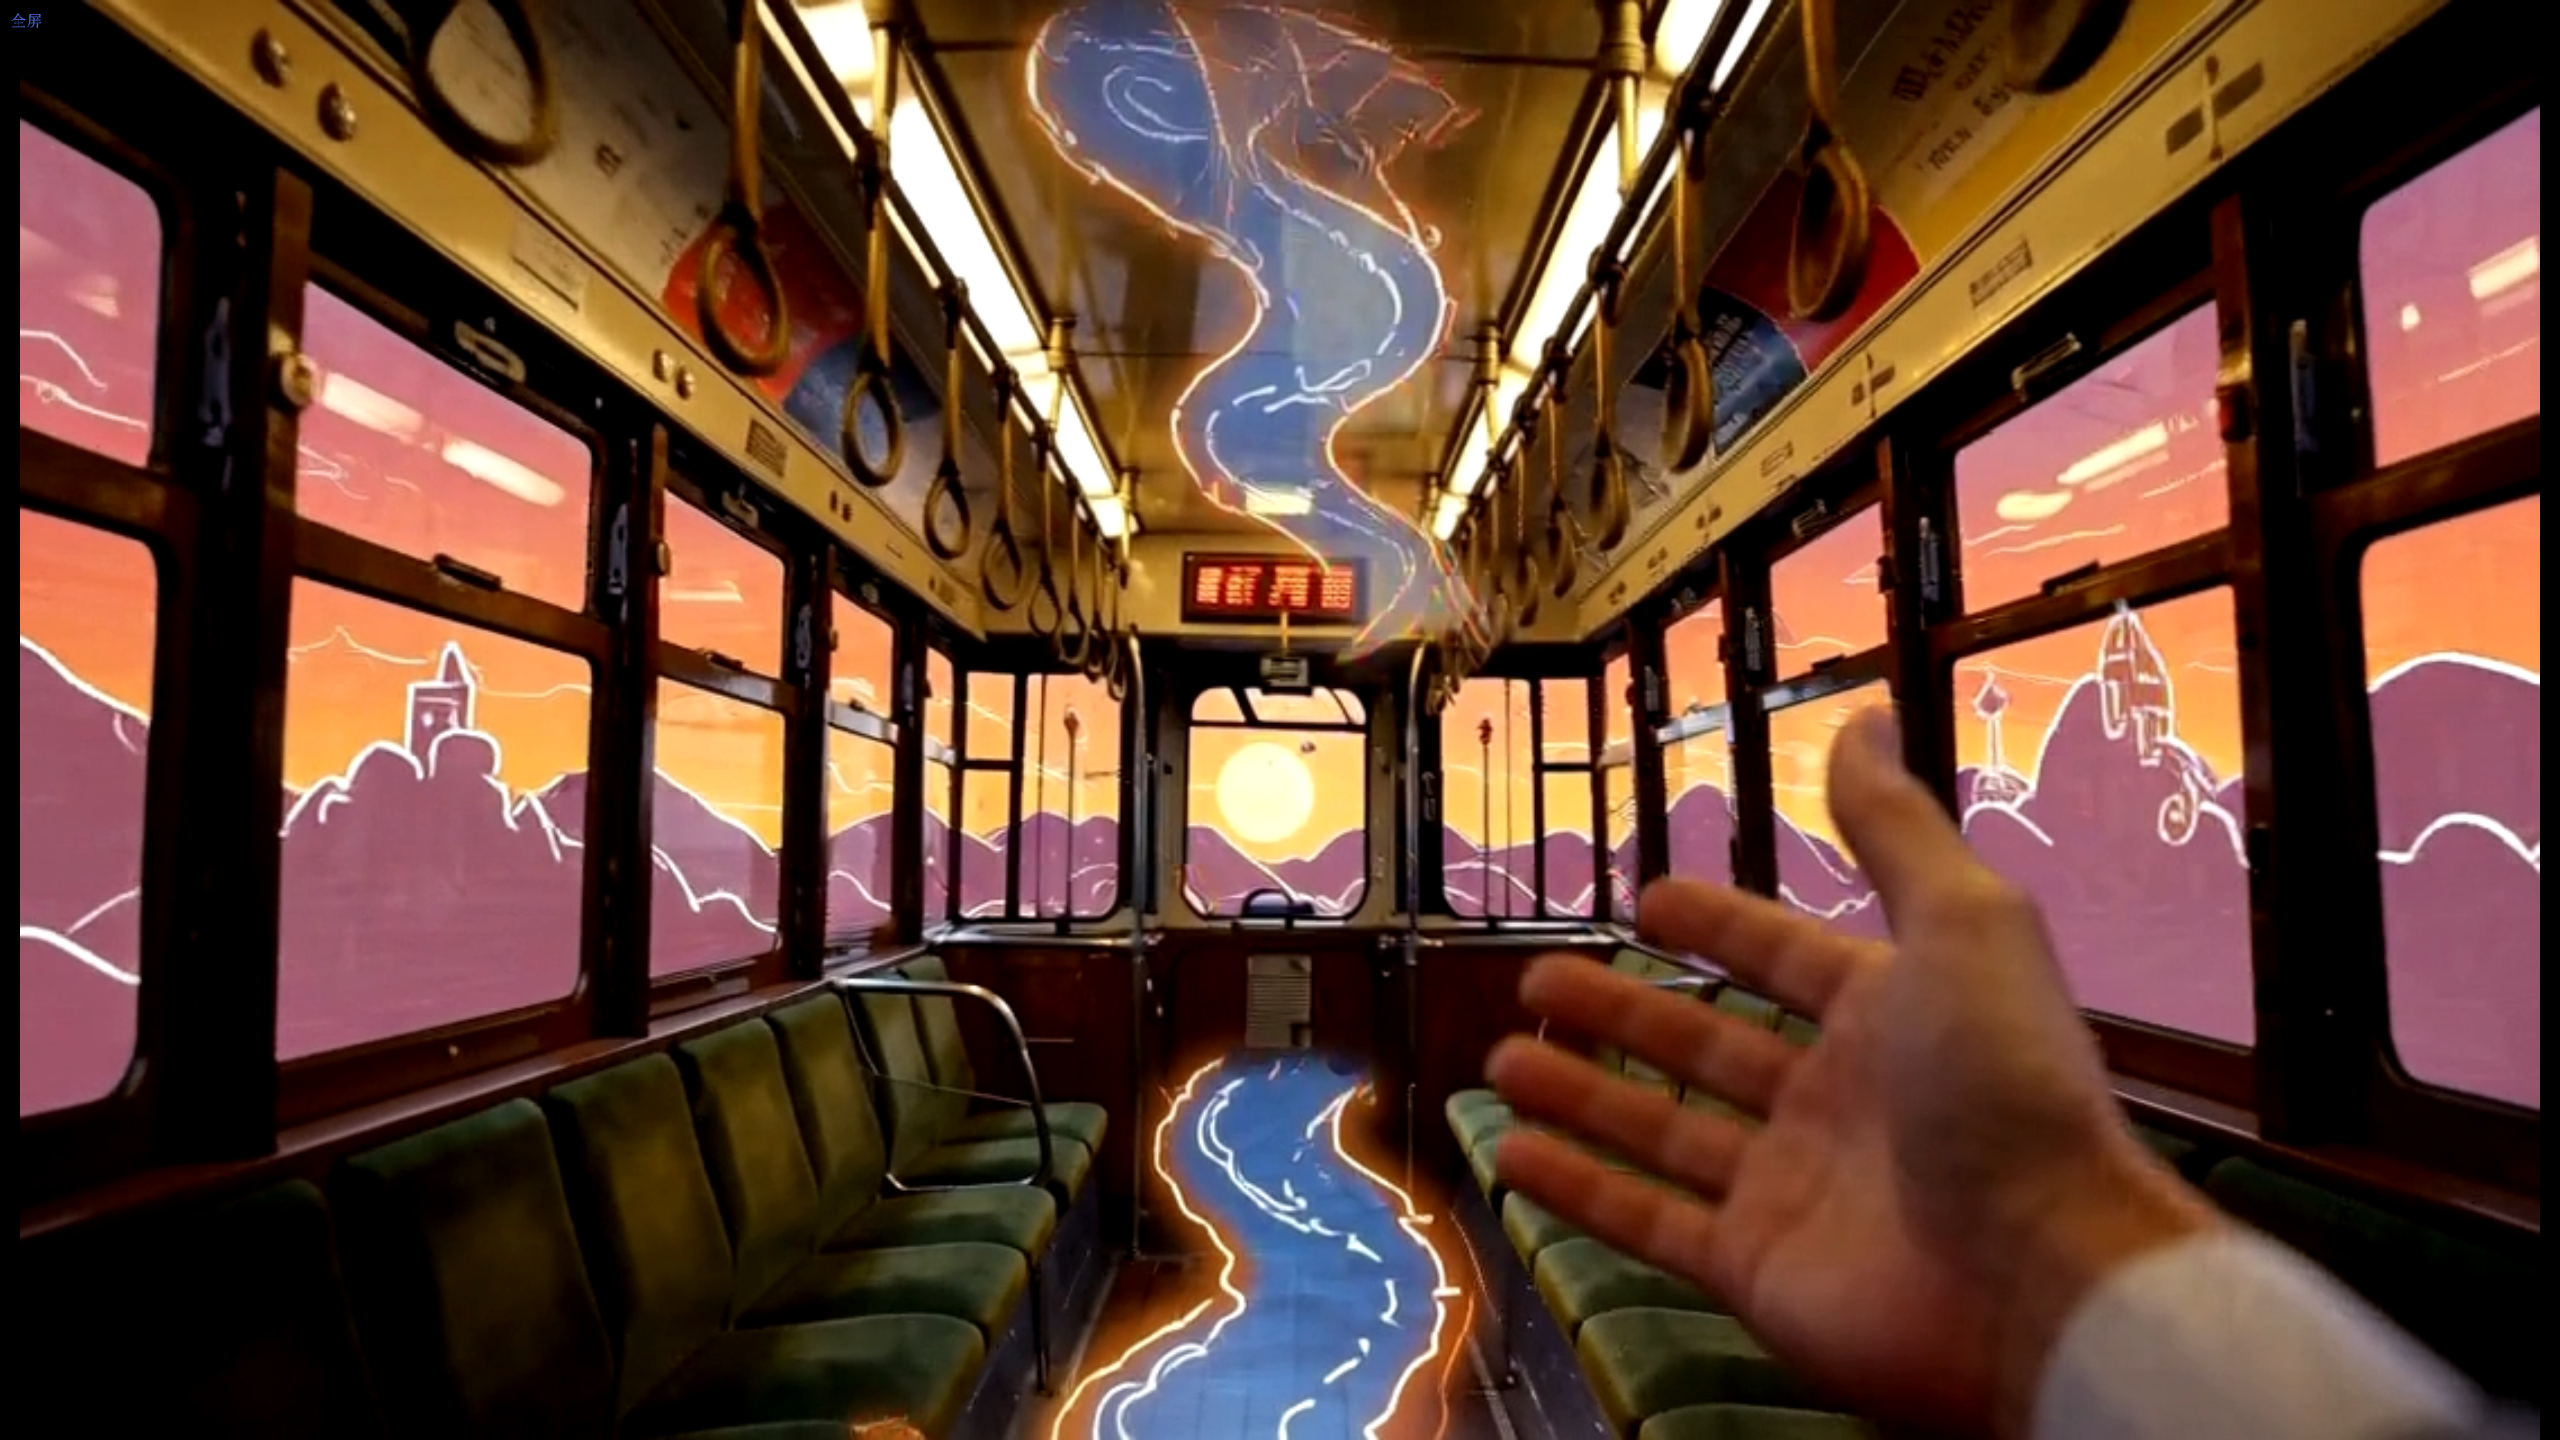
旧版整合包使用高清修复放大时可能出现接缝,新版本已修复:
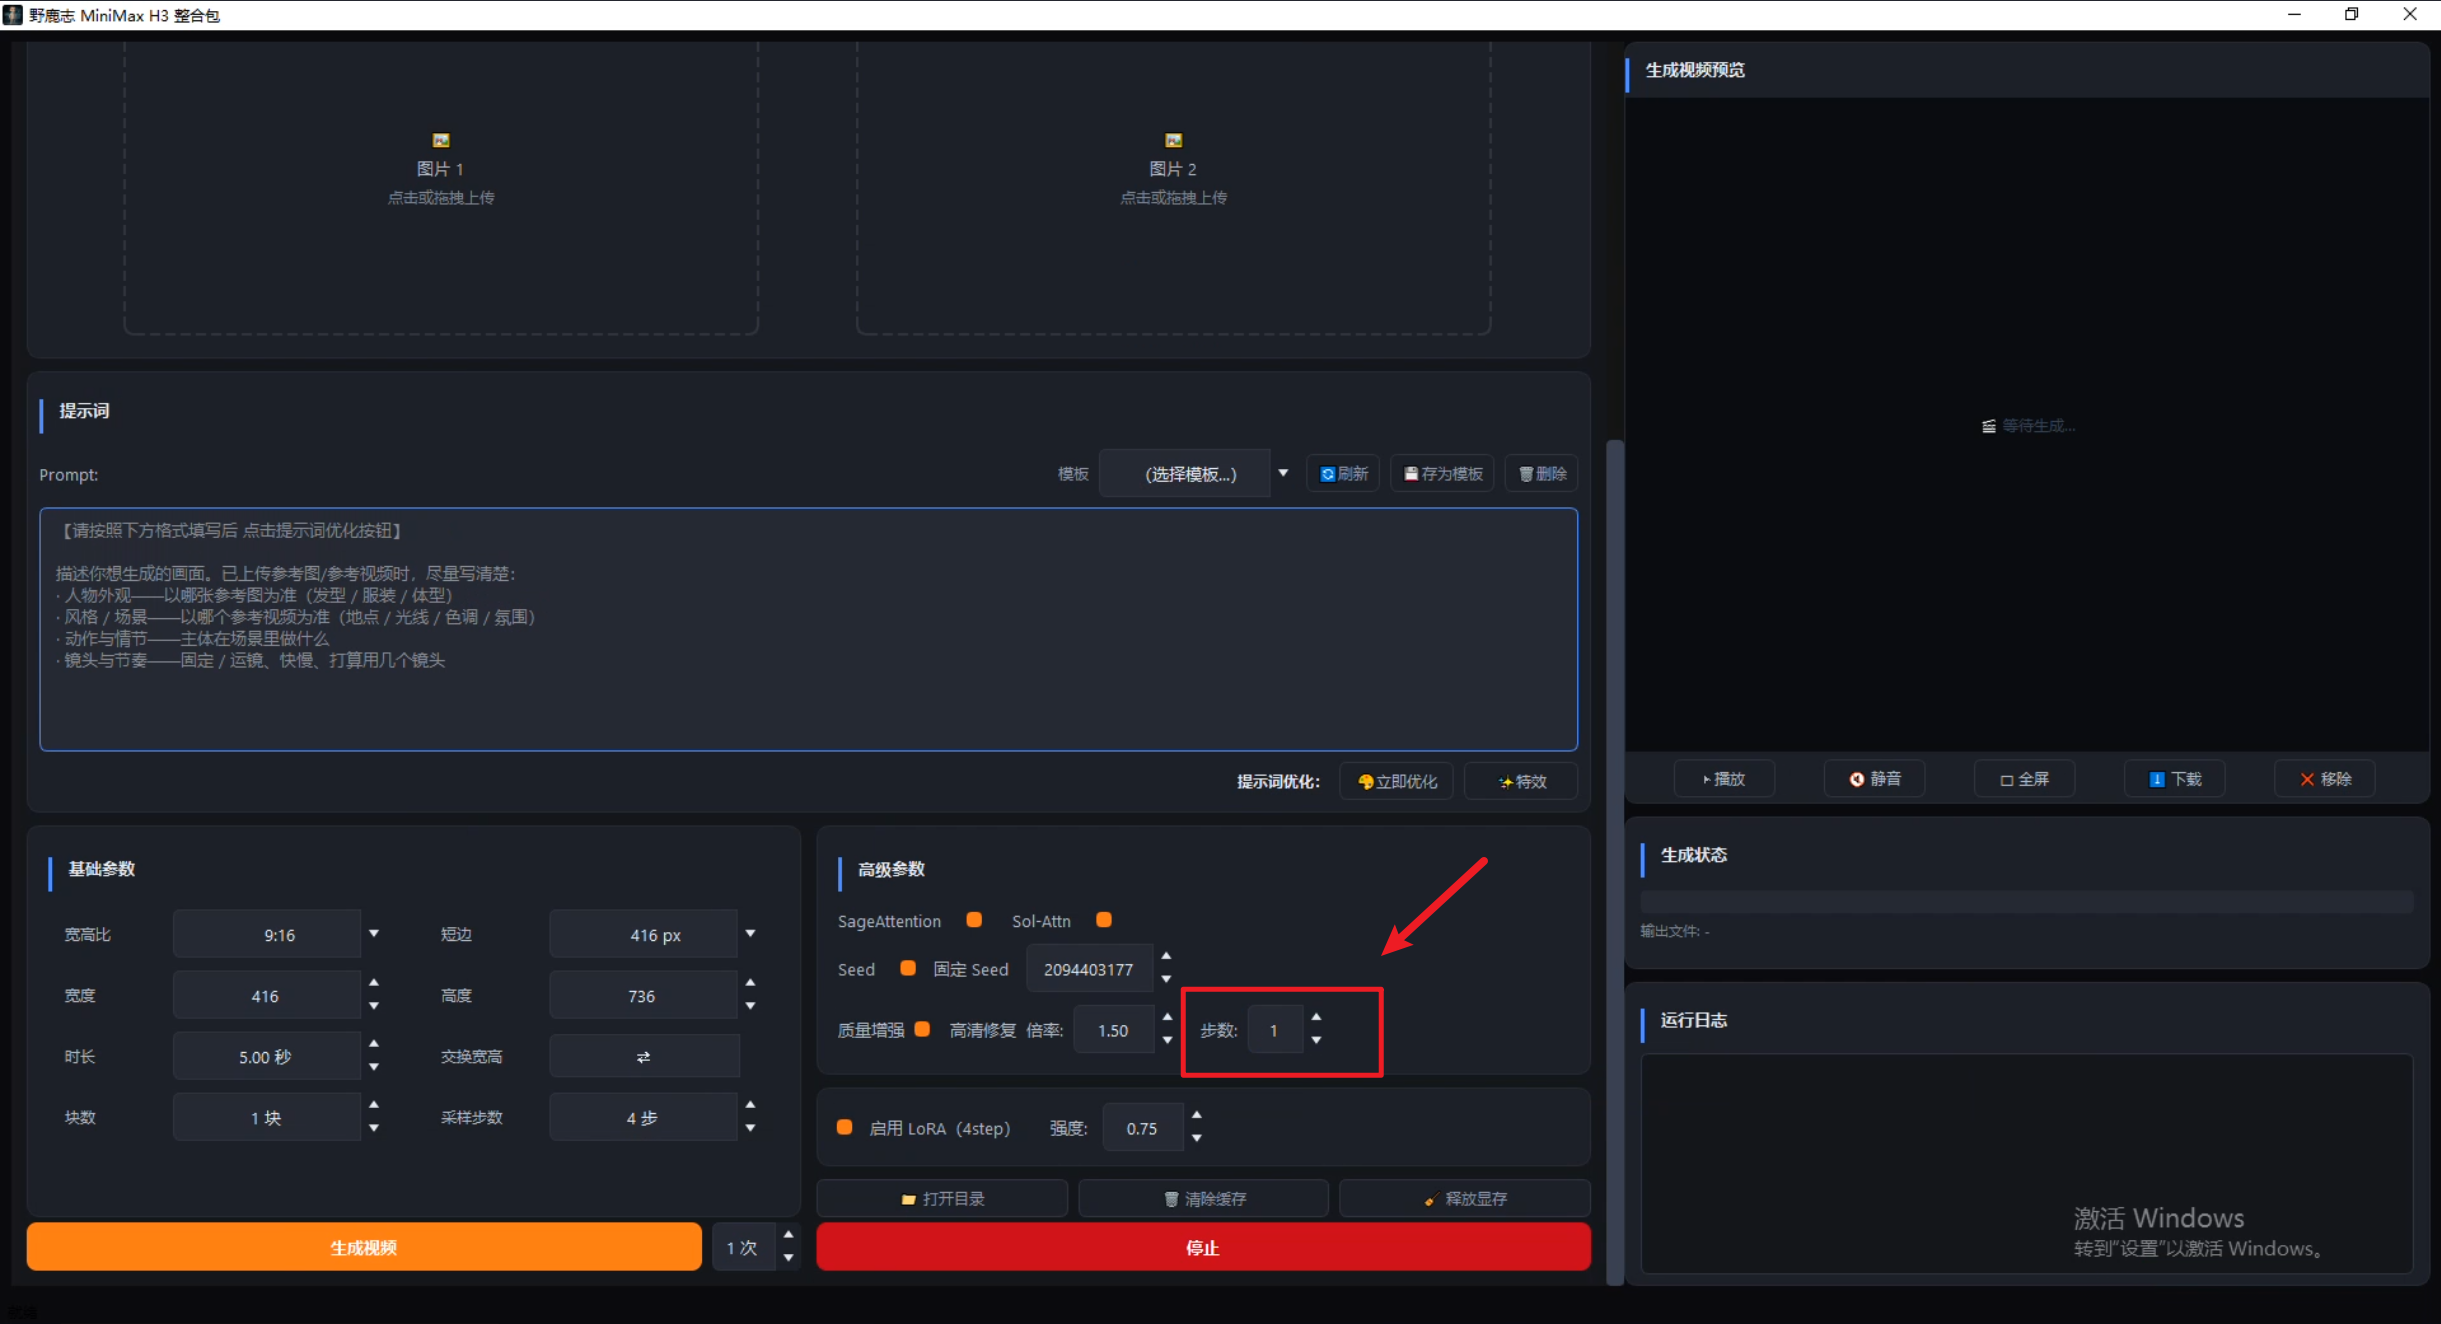
针对旧版本高清修复可能存在斑块的问题,这是因为旧版本默认高清修复采样步数为1步,为追求速度牺牲了质量。
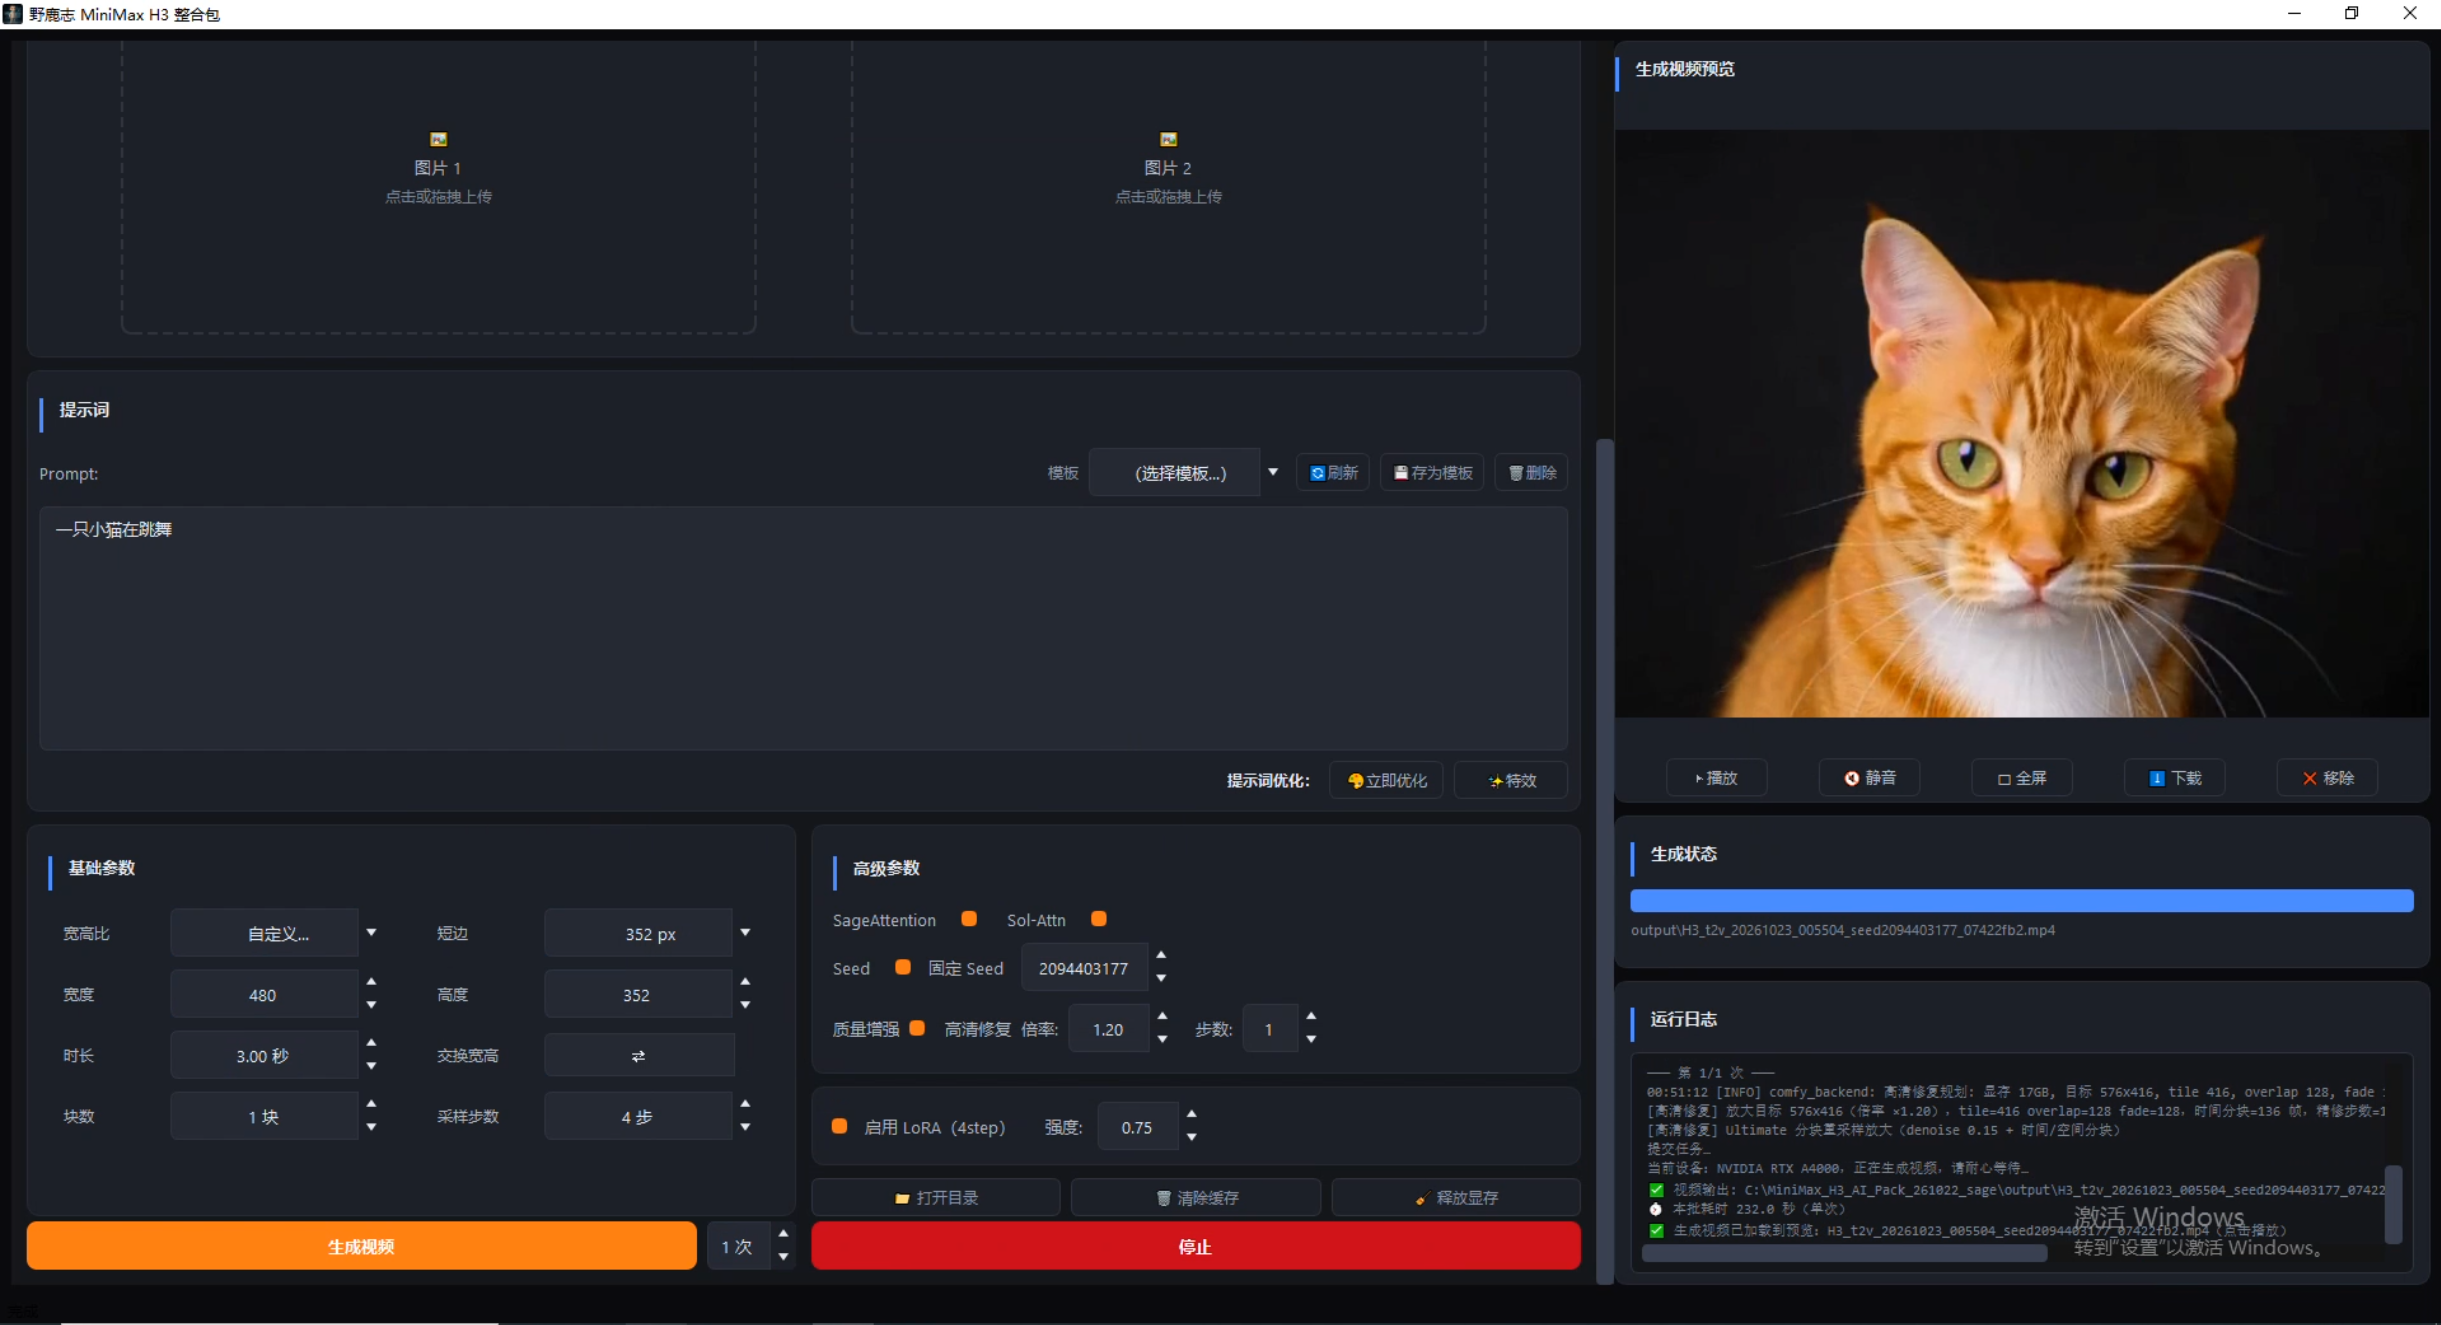
新版本已将高清修复的采样步数直接放到UI界面,大家可以根据自己的需求设置采样步数:
当然,提高采样步数后,生成时间也会增加。下方是采样步数为1和4时的效果与生成时间对比:
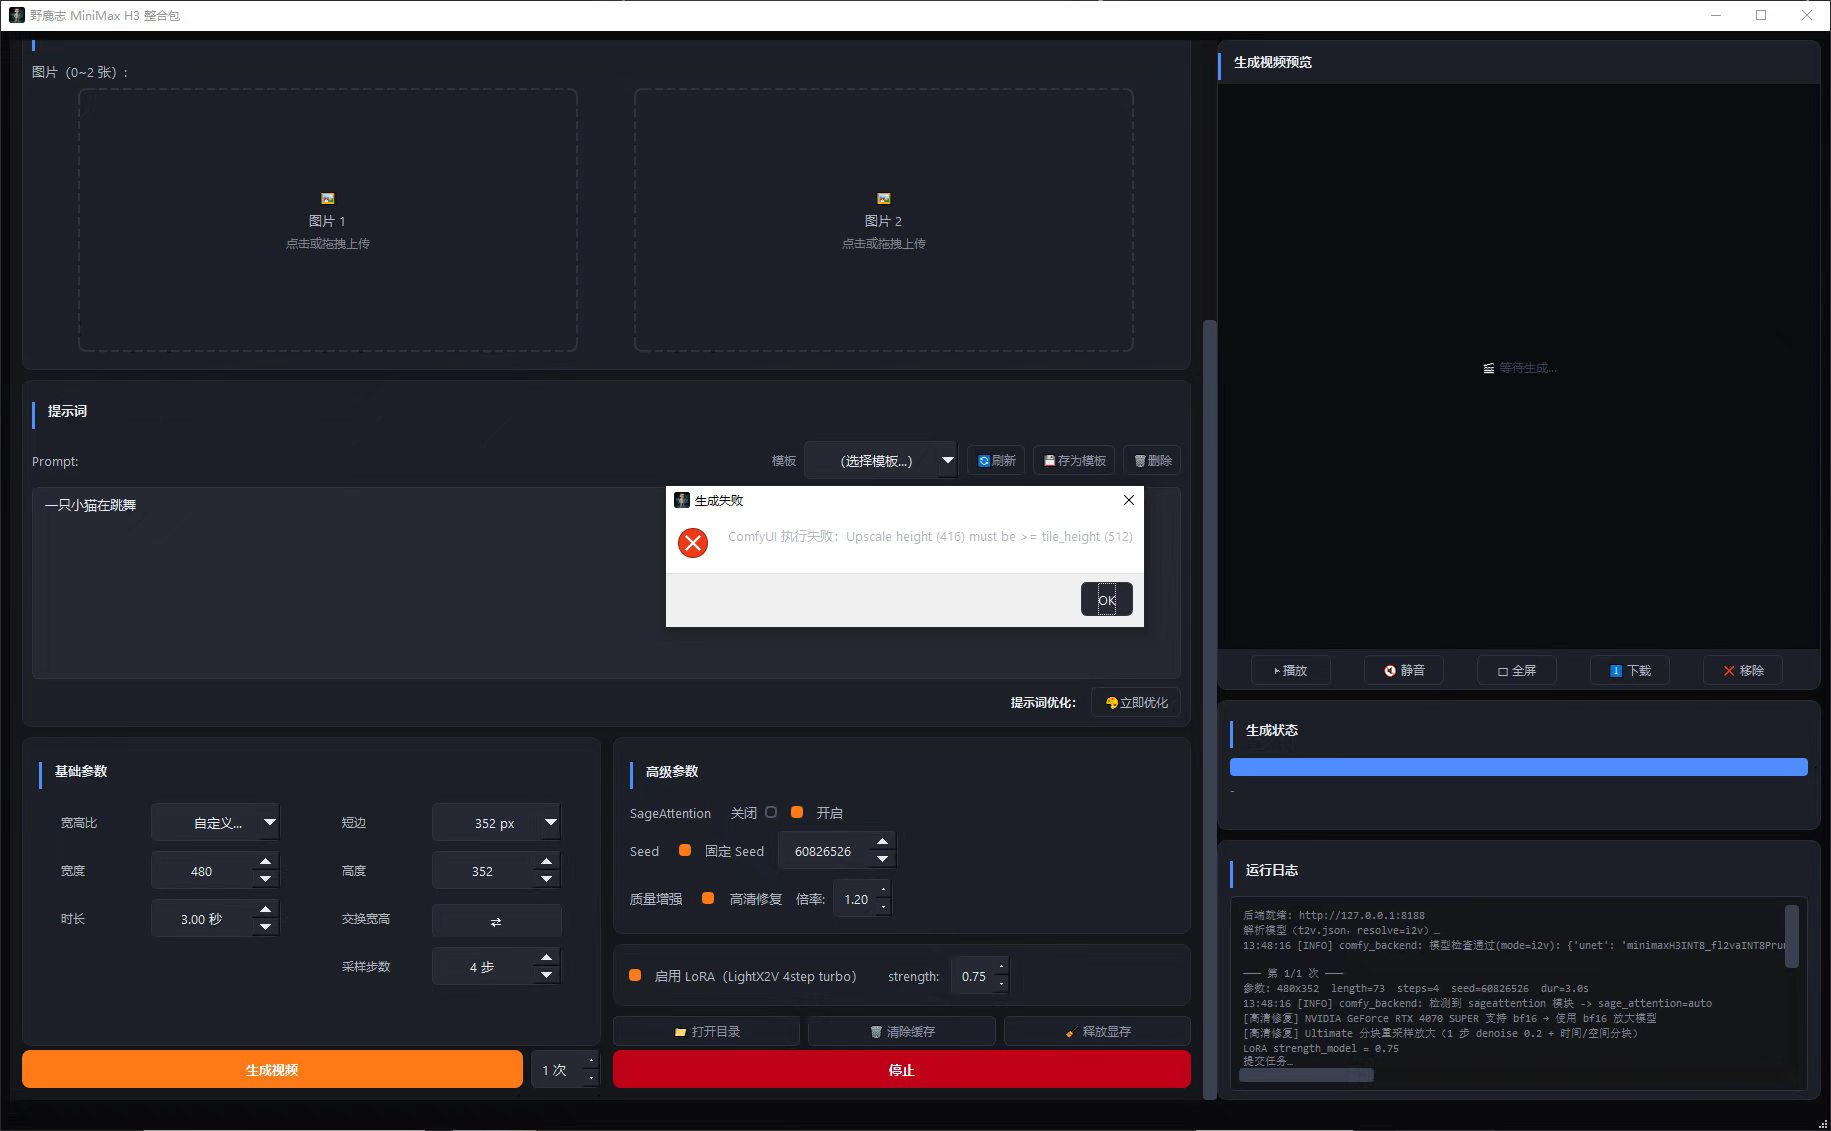
最后还修复了一些UI界面按钮显示错位的问题。但由于我只能在云电脑和本地电脑两台设备上测试,如果仍有问题,欢迎各位鹿友反馈。
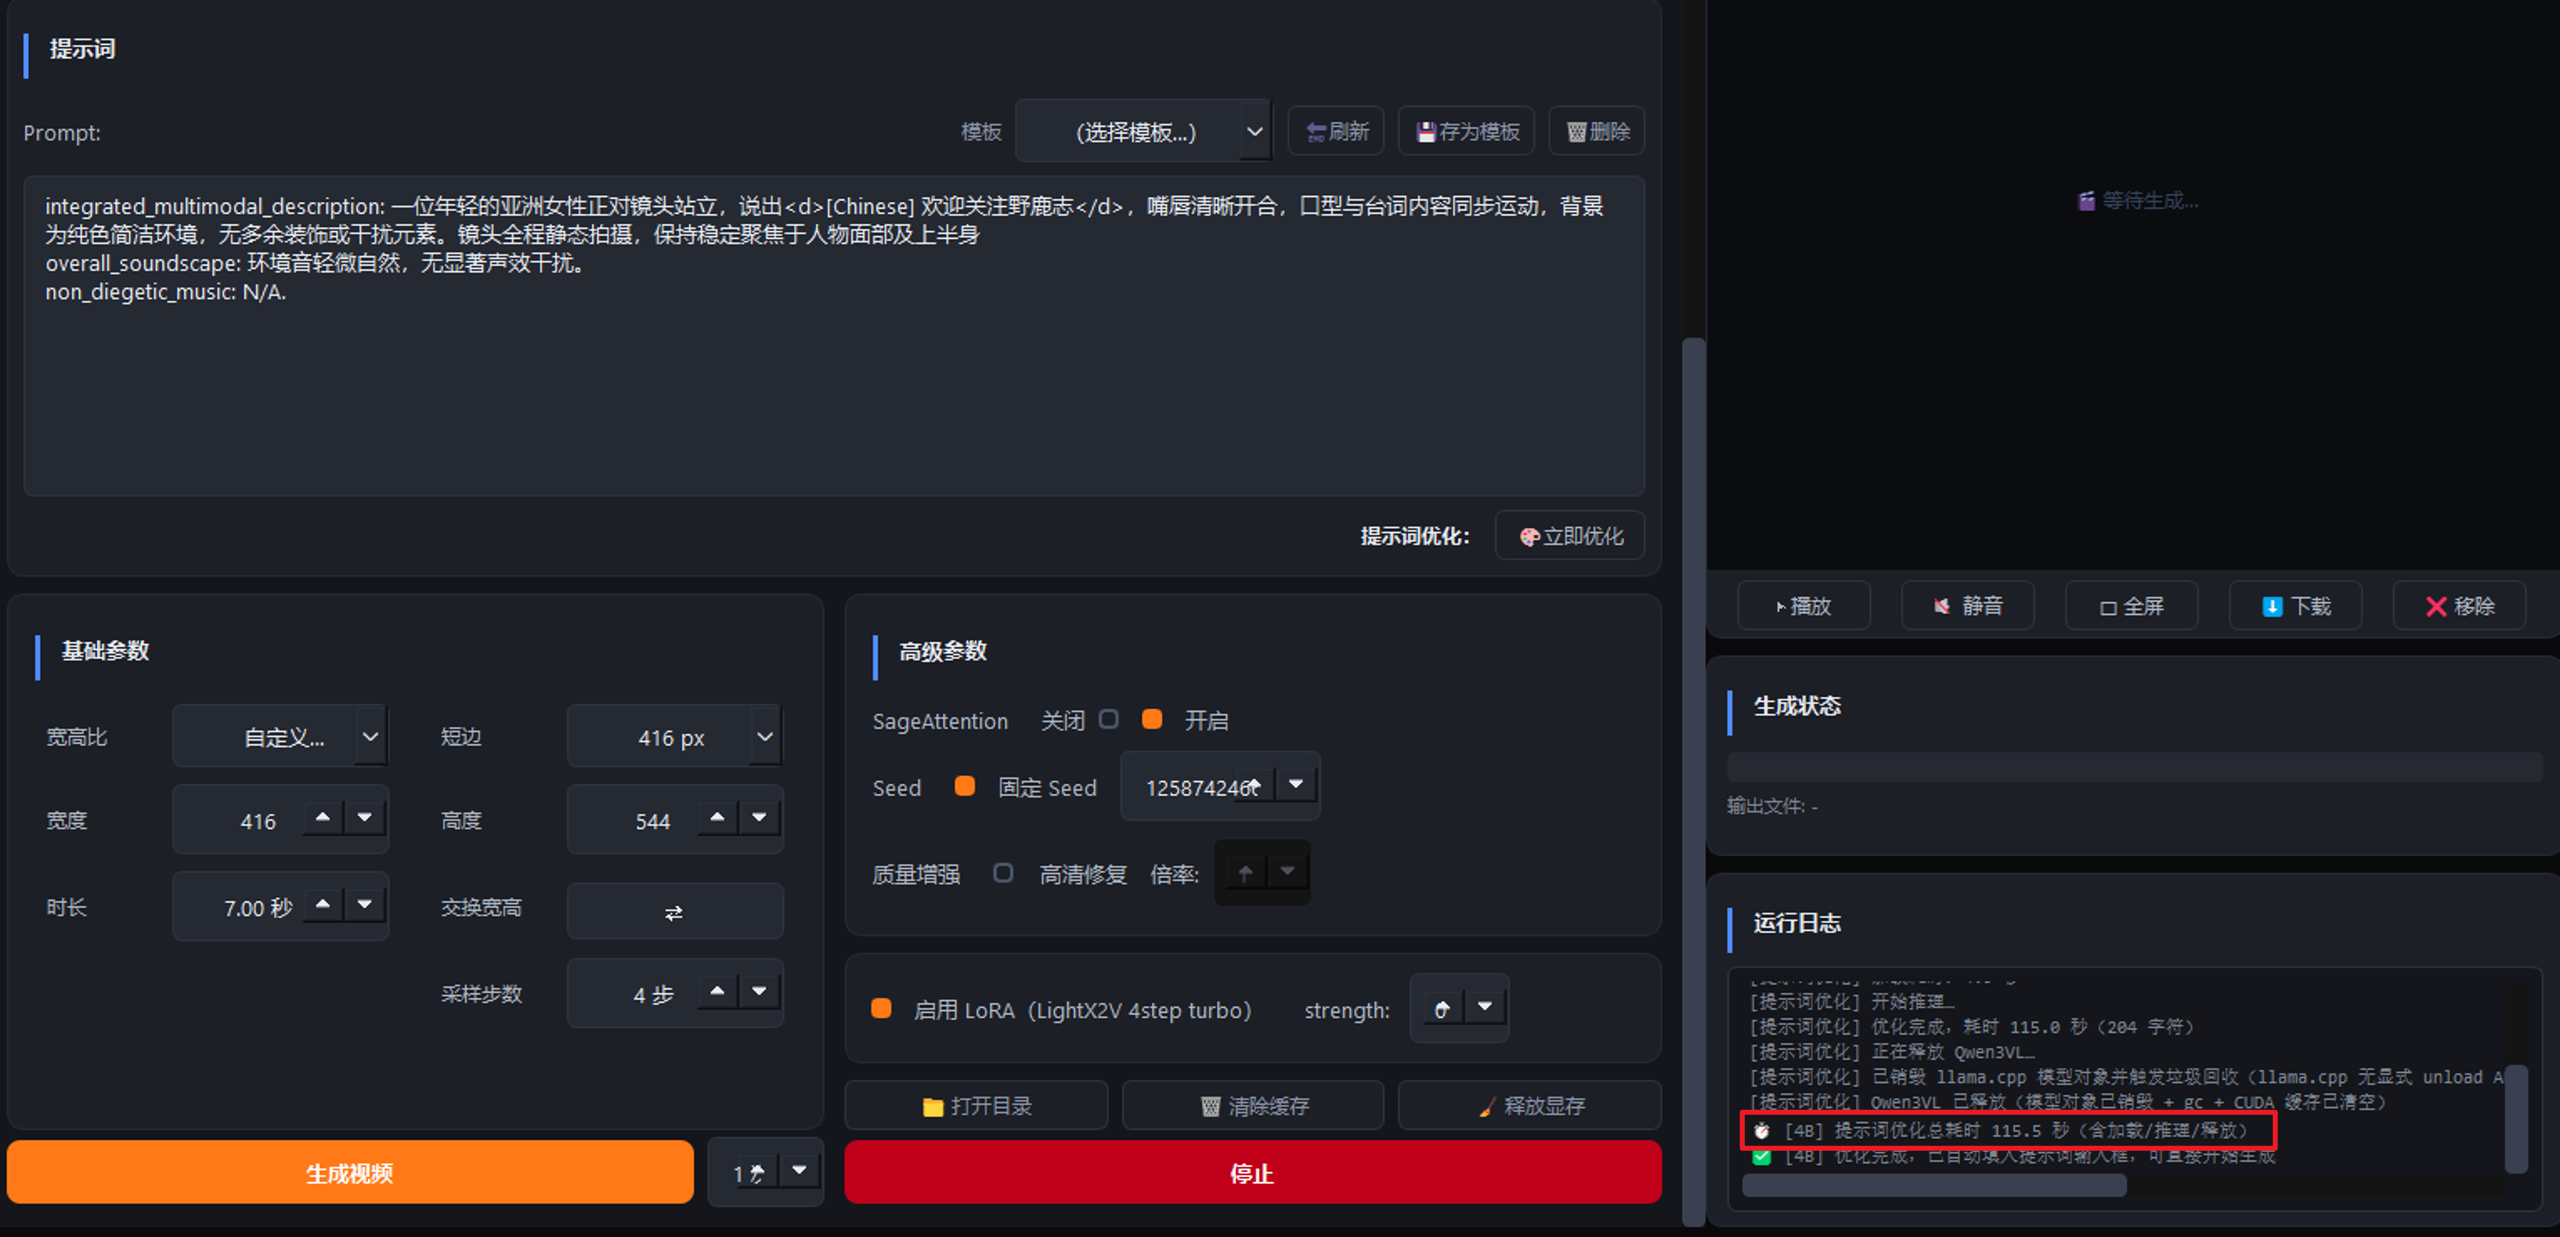
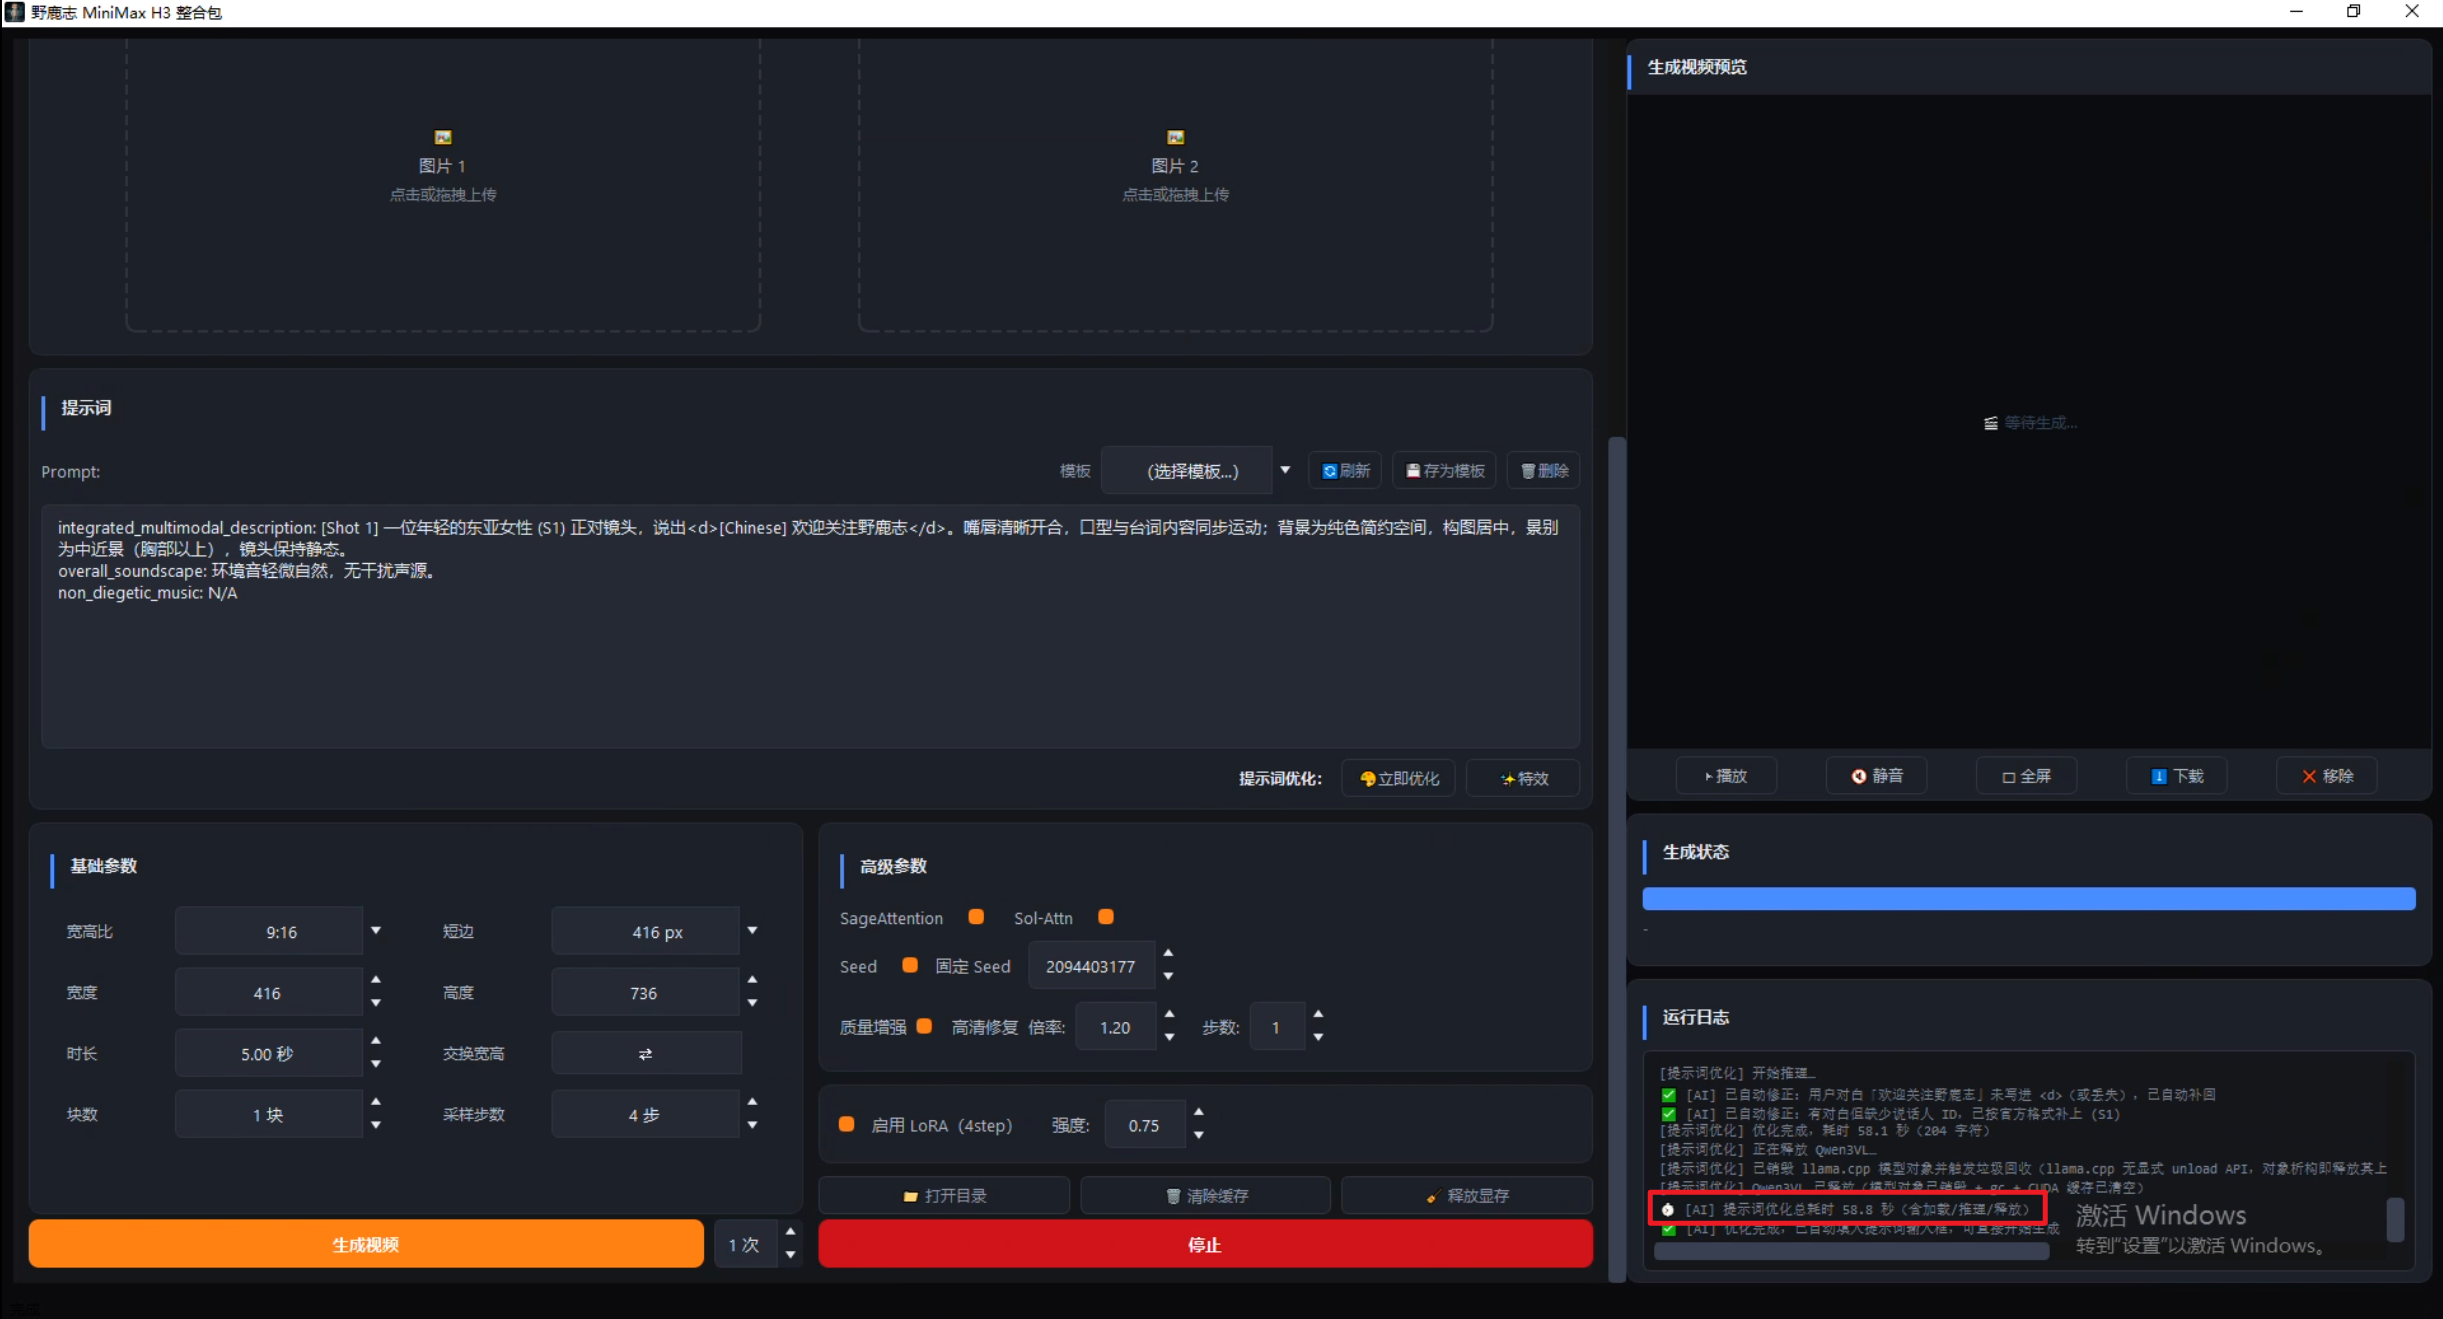
性能加速方面,首先优化了提示词优化功能的推理速度。旧版提示词优化普遍需要100多秒甚至200秒:
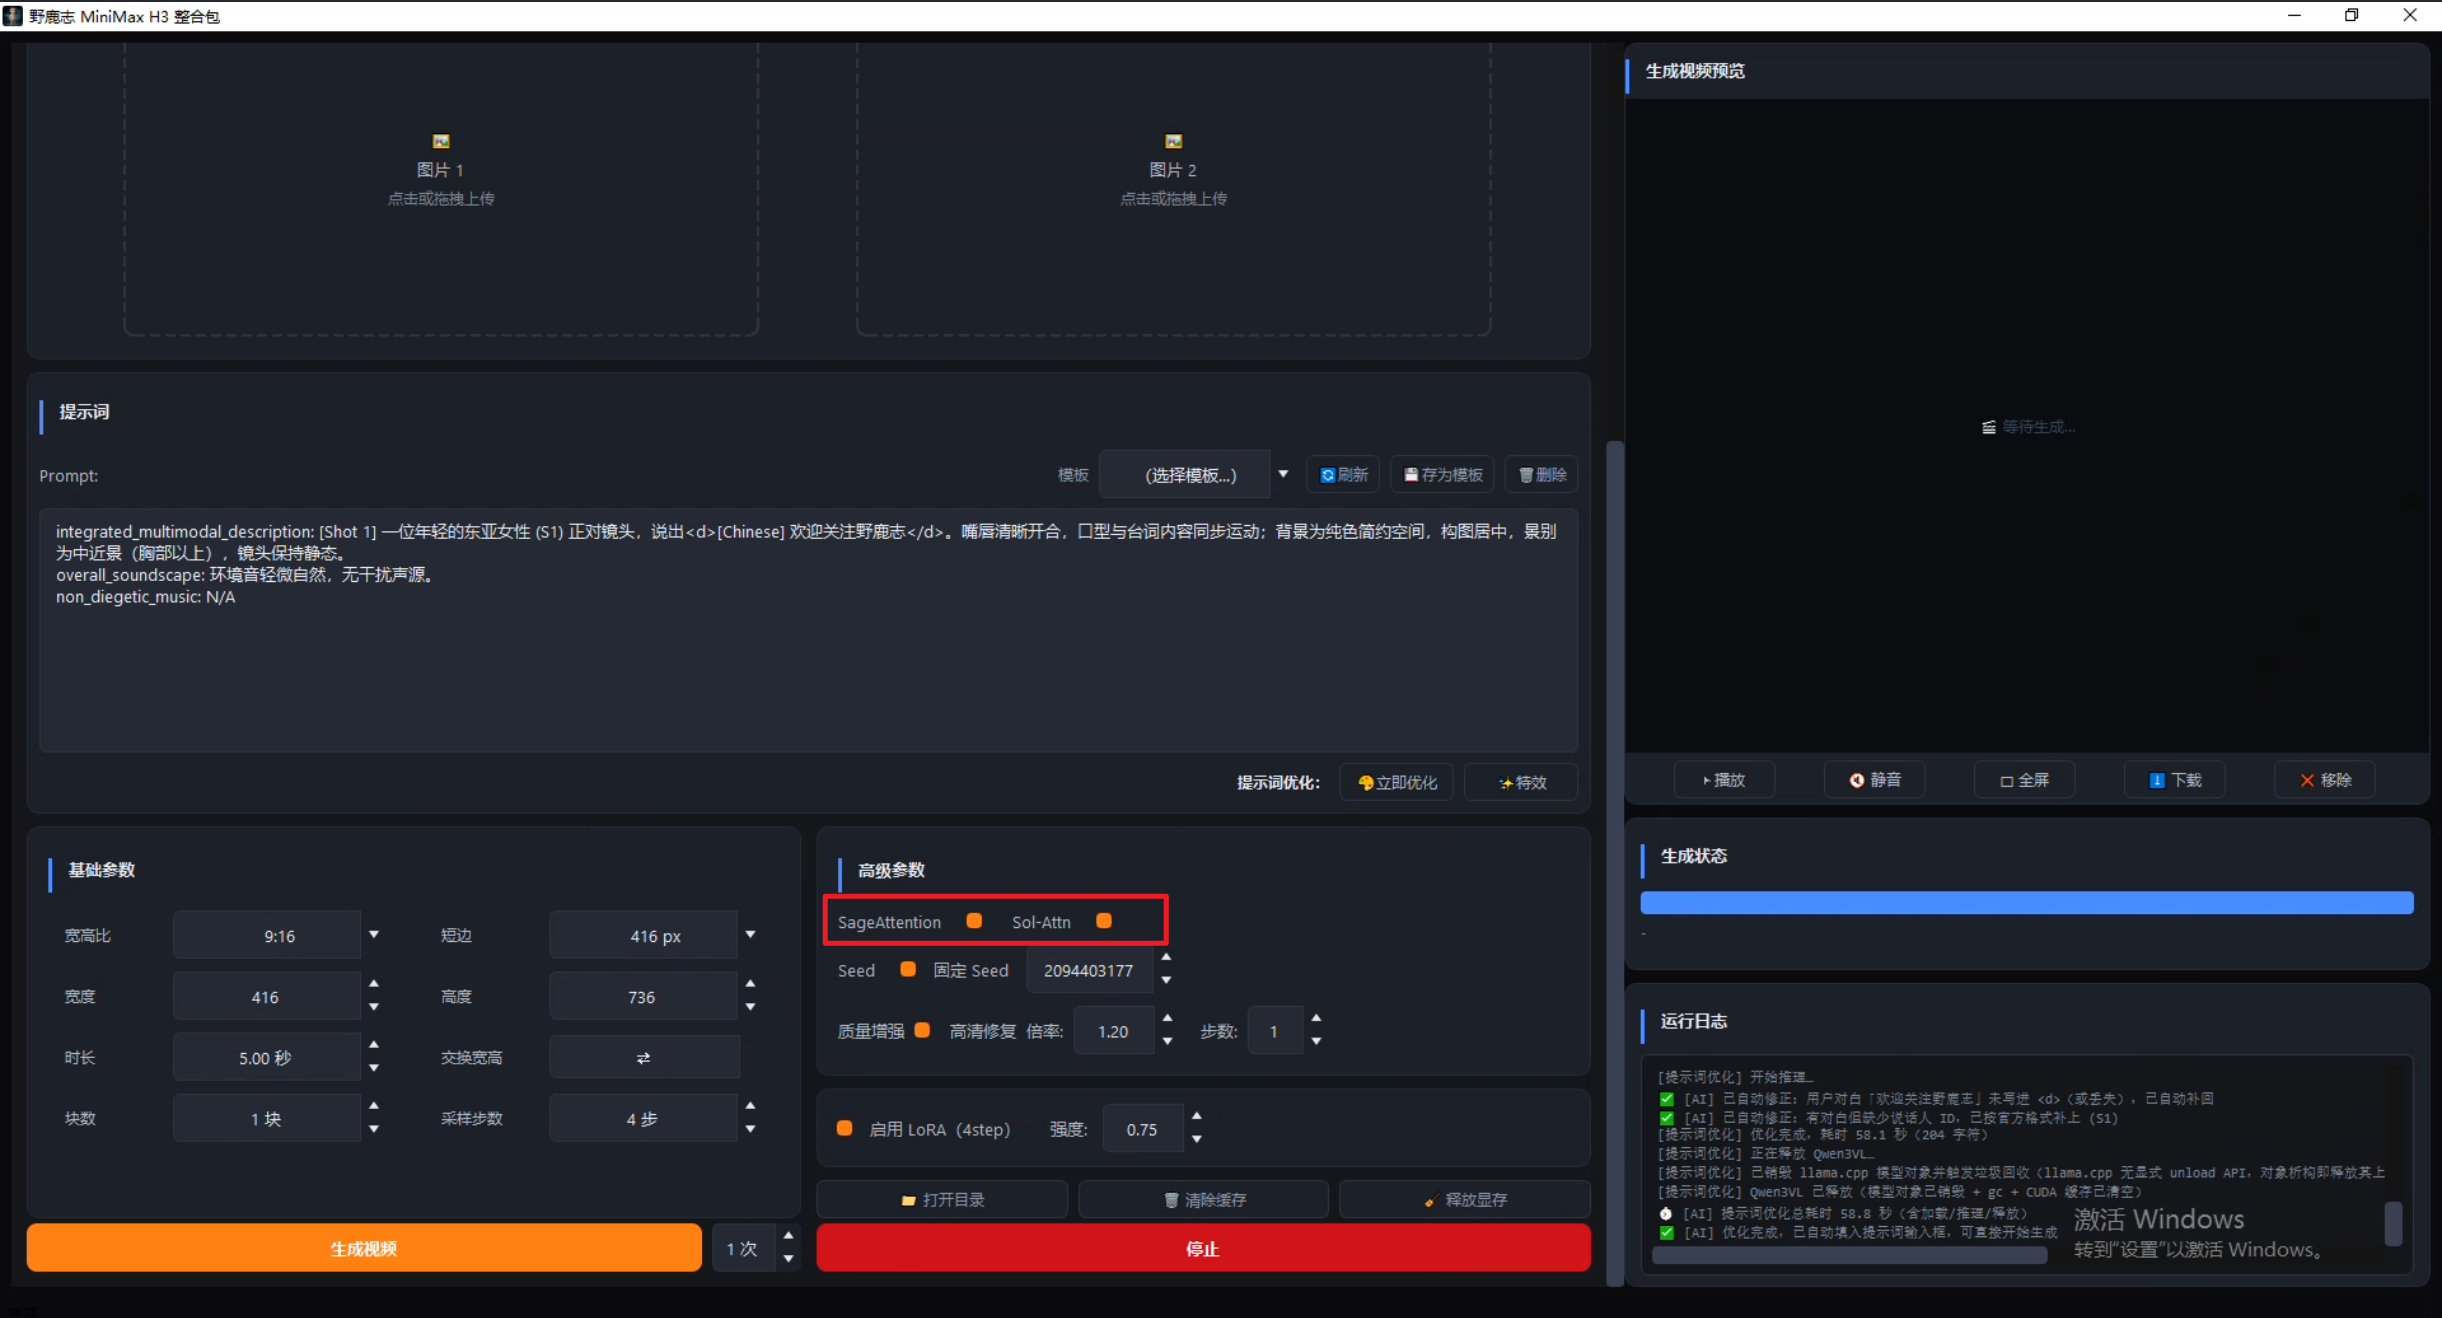
新增了 Sol-Attn 加速。需要提醒的是,SageAttention 和 Sol-Attn 加速两者可以叠加,但都会损失一定的生成质量,因此我将这两个加速选项都做成了开关,供大家自行选择:
Sol-Attn 加速首次运行时,需要为你的显卡现场编译并调优加速内核,因此开启 Sol-Attn 后,你可能会感觉反而更慢。
不过,这些结果会缓存到硬盘;此后只要分辨率、时长等参数不变,再抽卡时就会直接复用缓存,不再有额外等待。
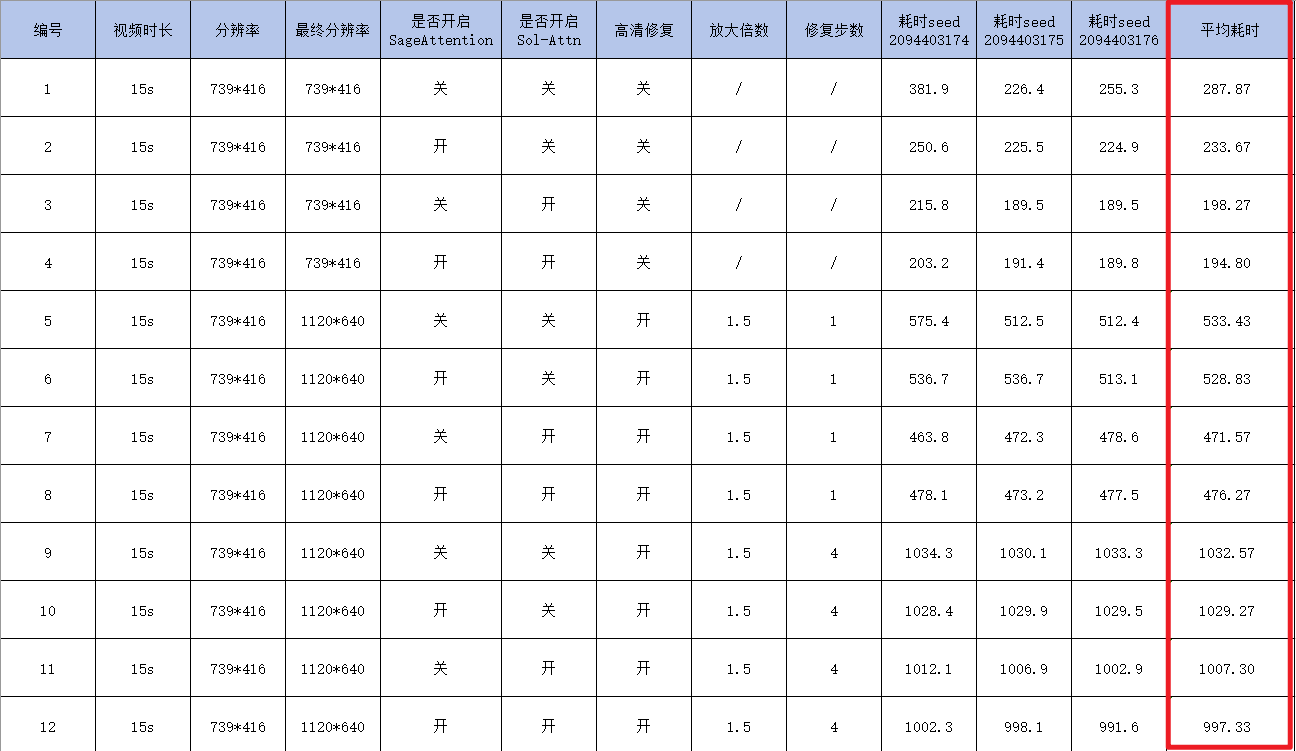
下方是我对加速功能的耗时测试对照表,供大家参考。测试设备:显卡A4000,显存16G,内存32G
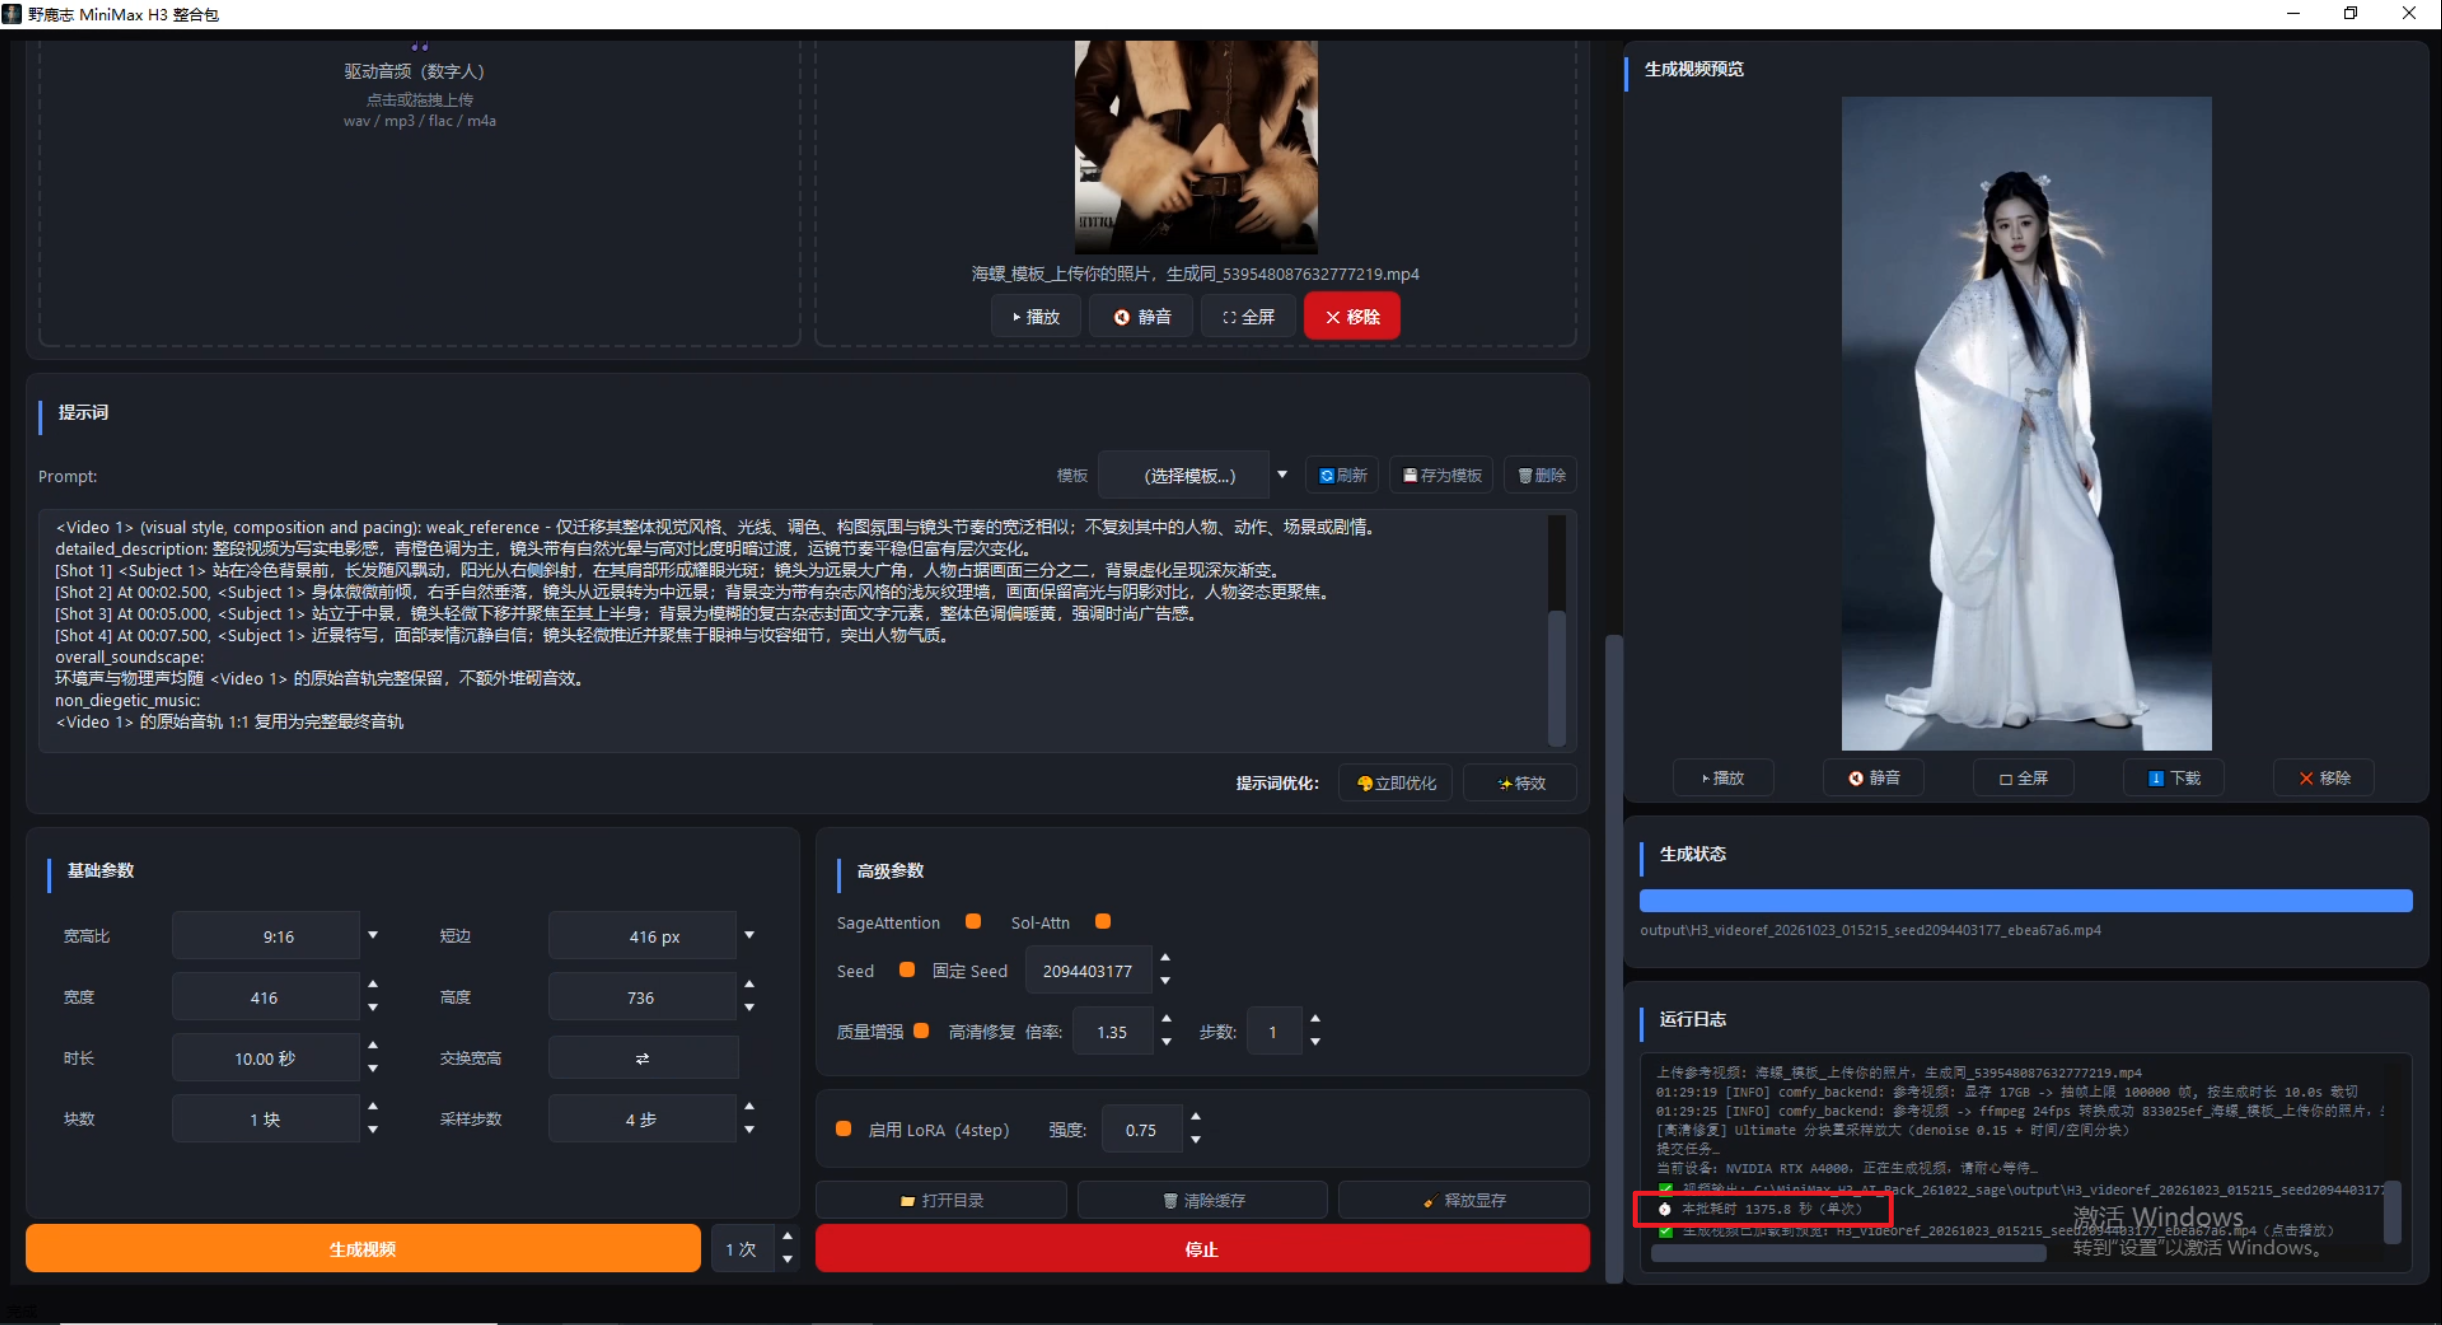
旧版整合包的文章里我就提到过,参考视频模式是最消耗资源的一种:
“上传10秒参考视频,生成416×736分辨率的视频后再放大1.35倍,耗时超过40分钟。”
新版整合包优化了上传素材的尺寸,在同样的生成条件下,耗时缩短了一半:
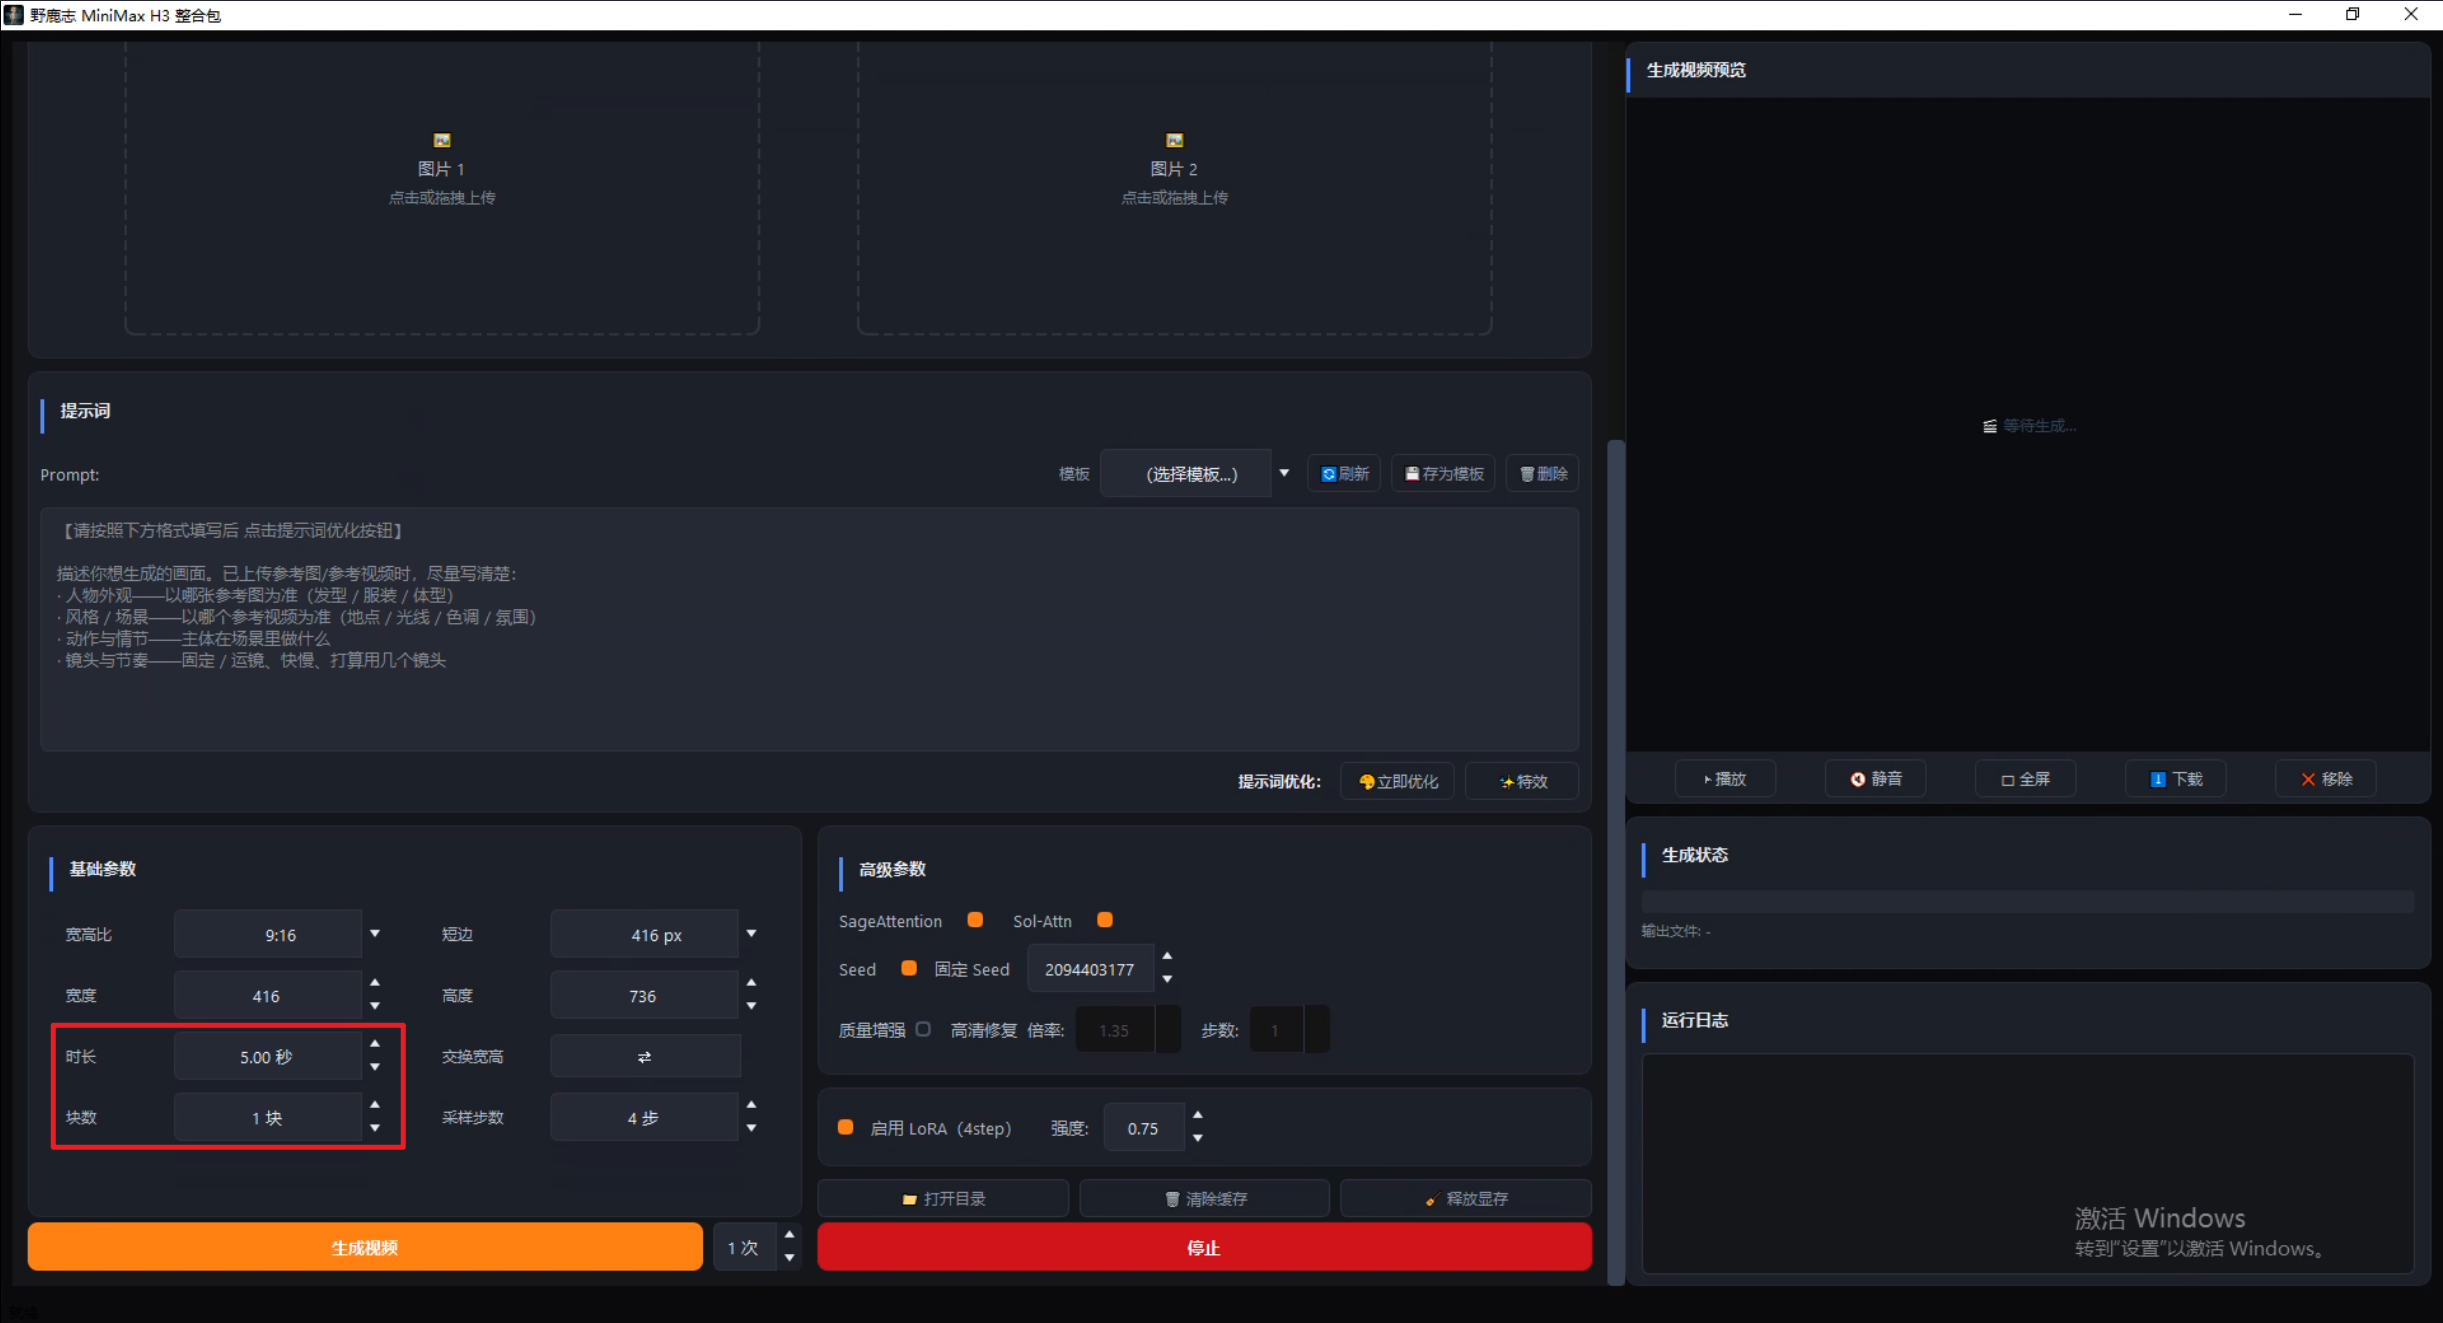
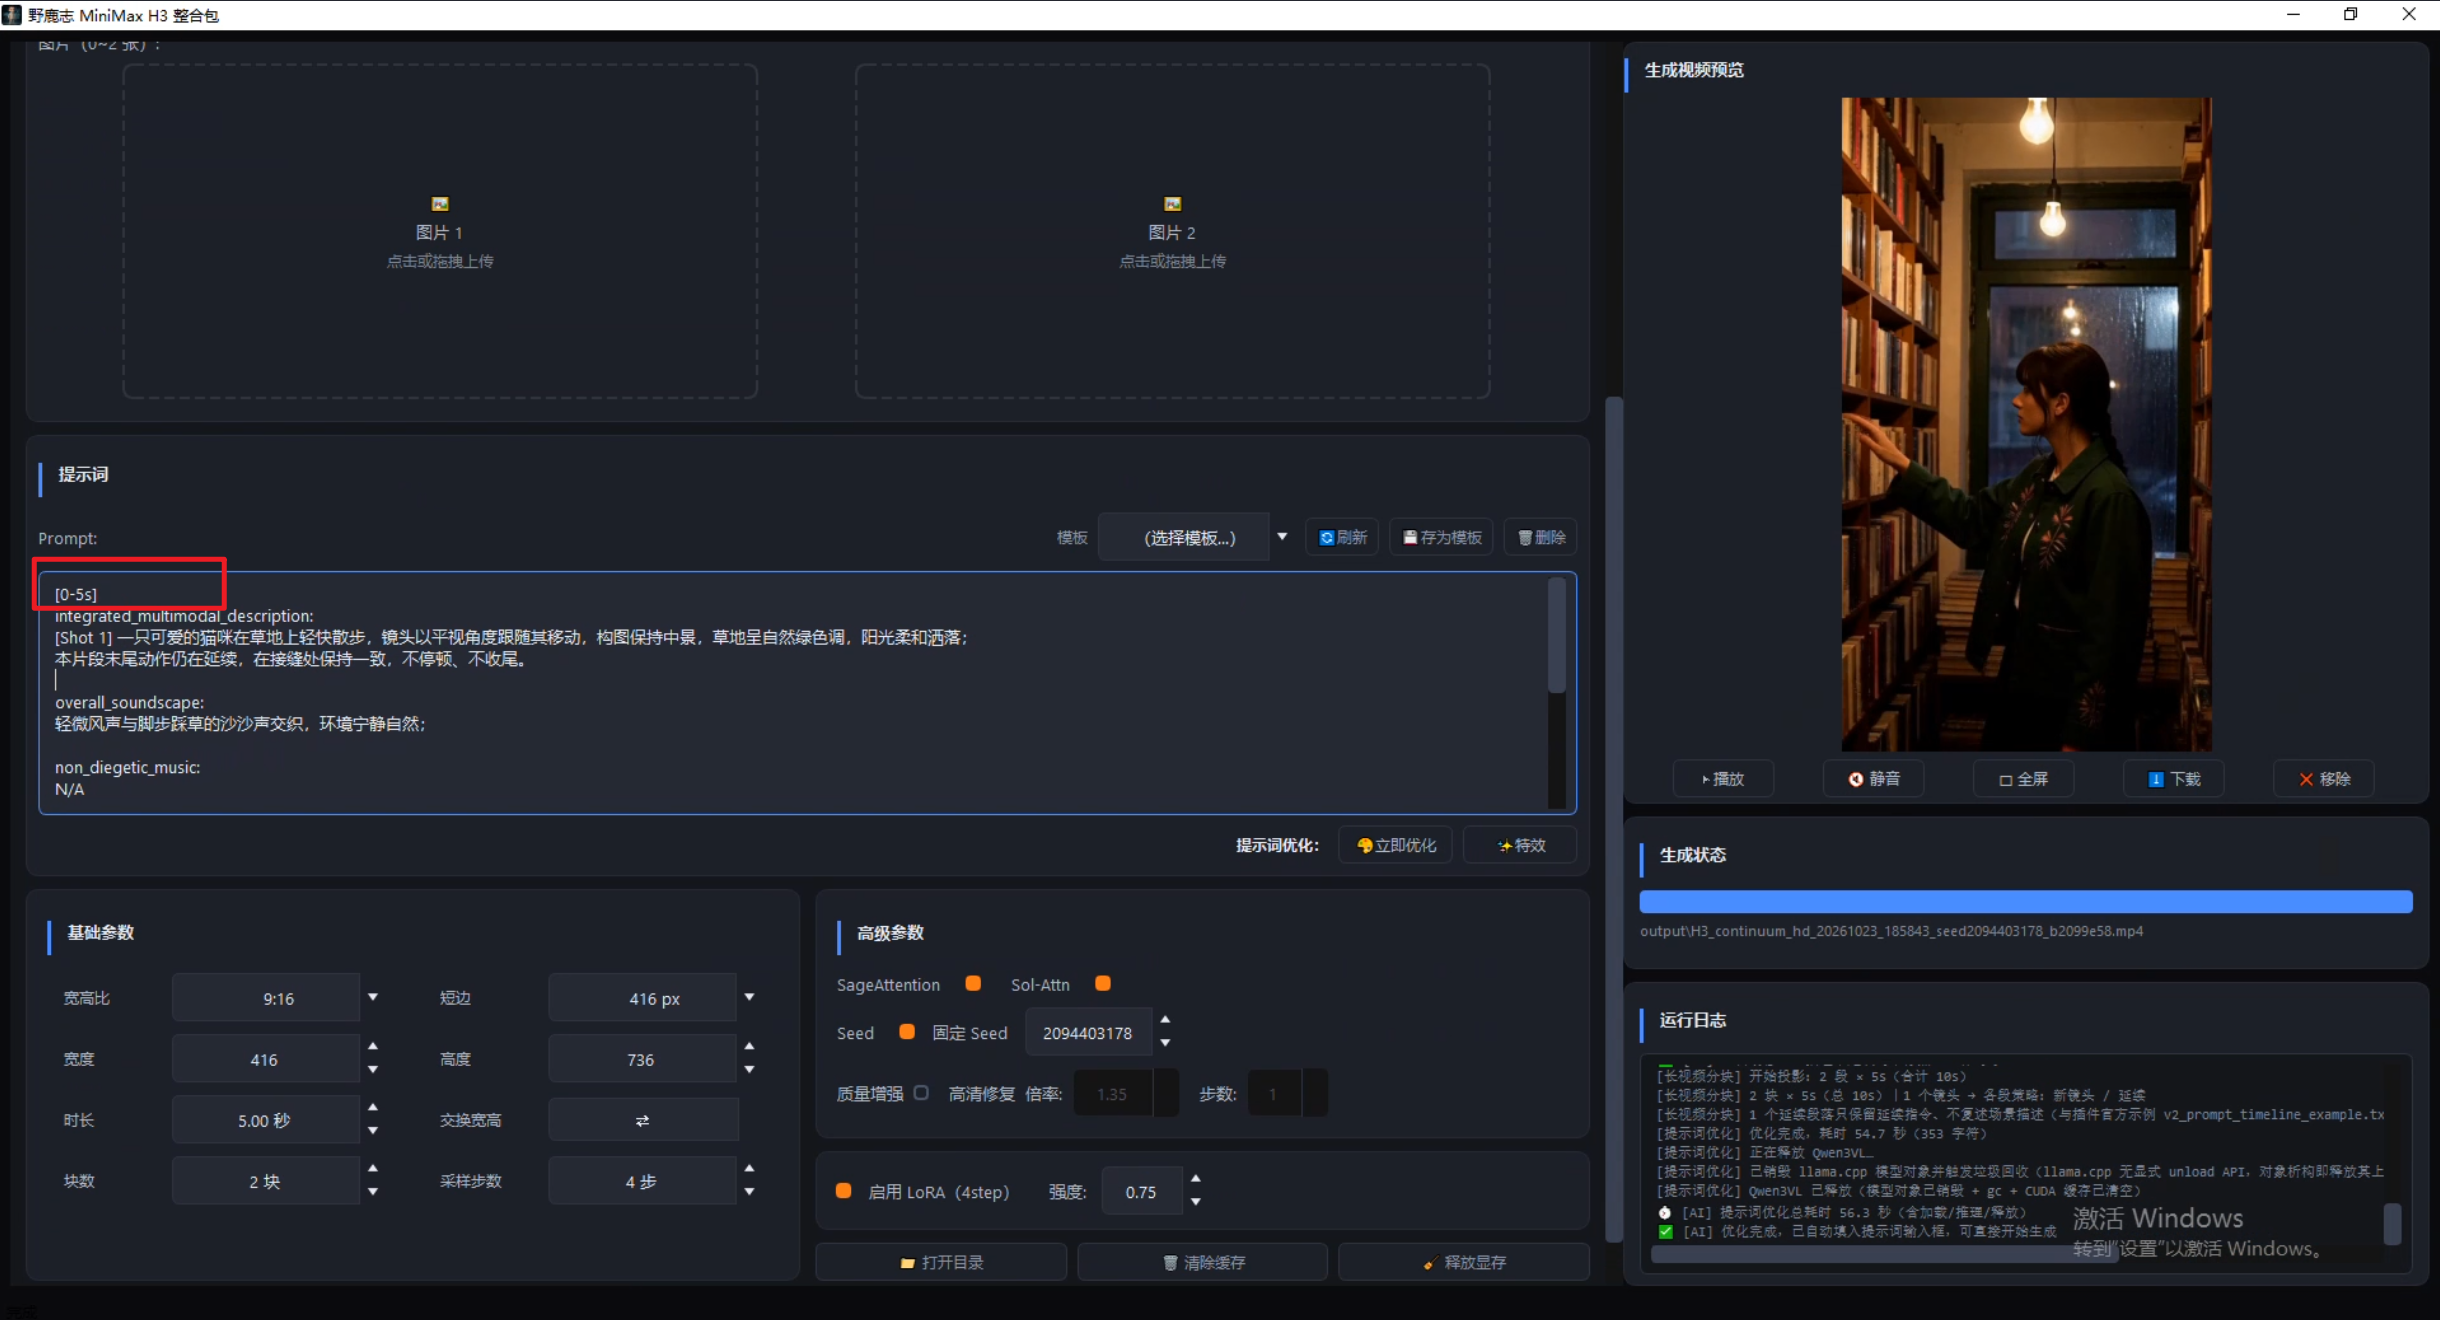
新增长视频模式:官方 H3 最长只能生成15秒视频,现在可通过块数和时长两个参数控制,生成超过15秒的视频:
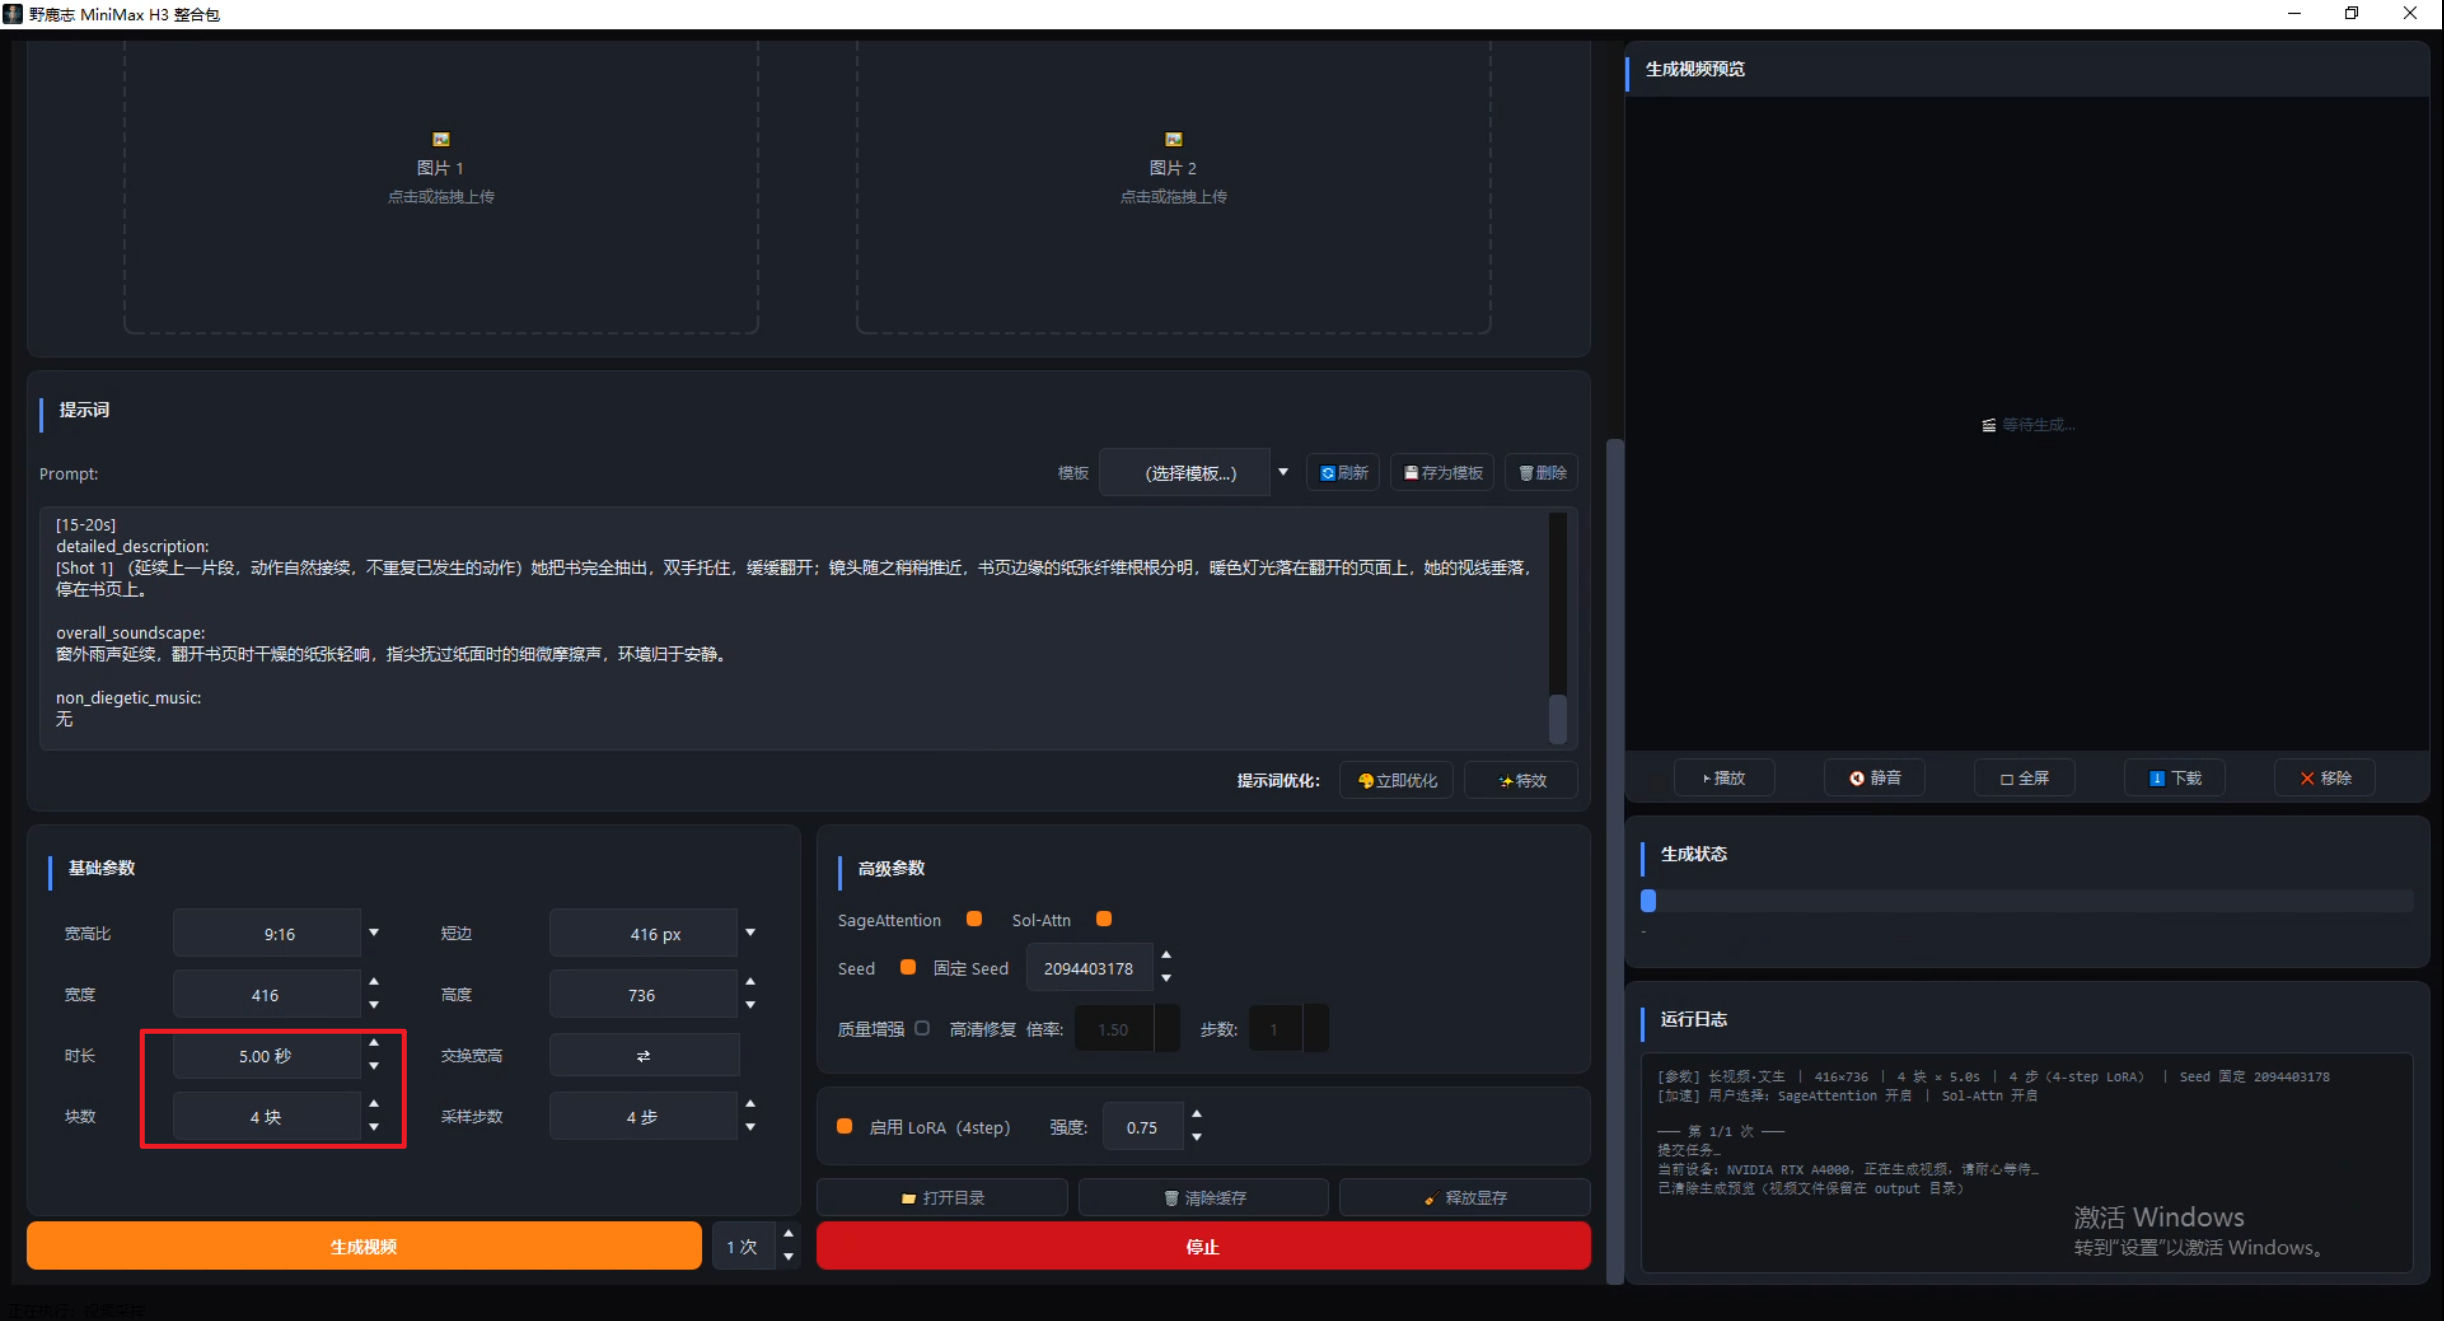
块数为1时是普通模式;块数大于等于2时即为长视频模式。此时时长最低设为4秒,最高设为15秒。例如块数为4、时长为5,即生成20秒视频:
文生/图生视频及全能参考均支持长视频模式,且支持高清修复。
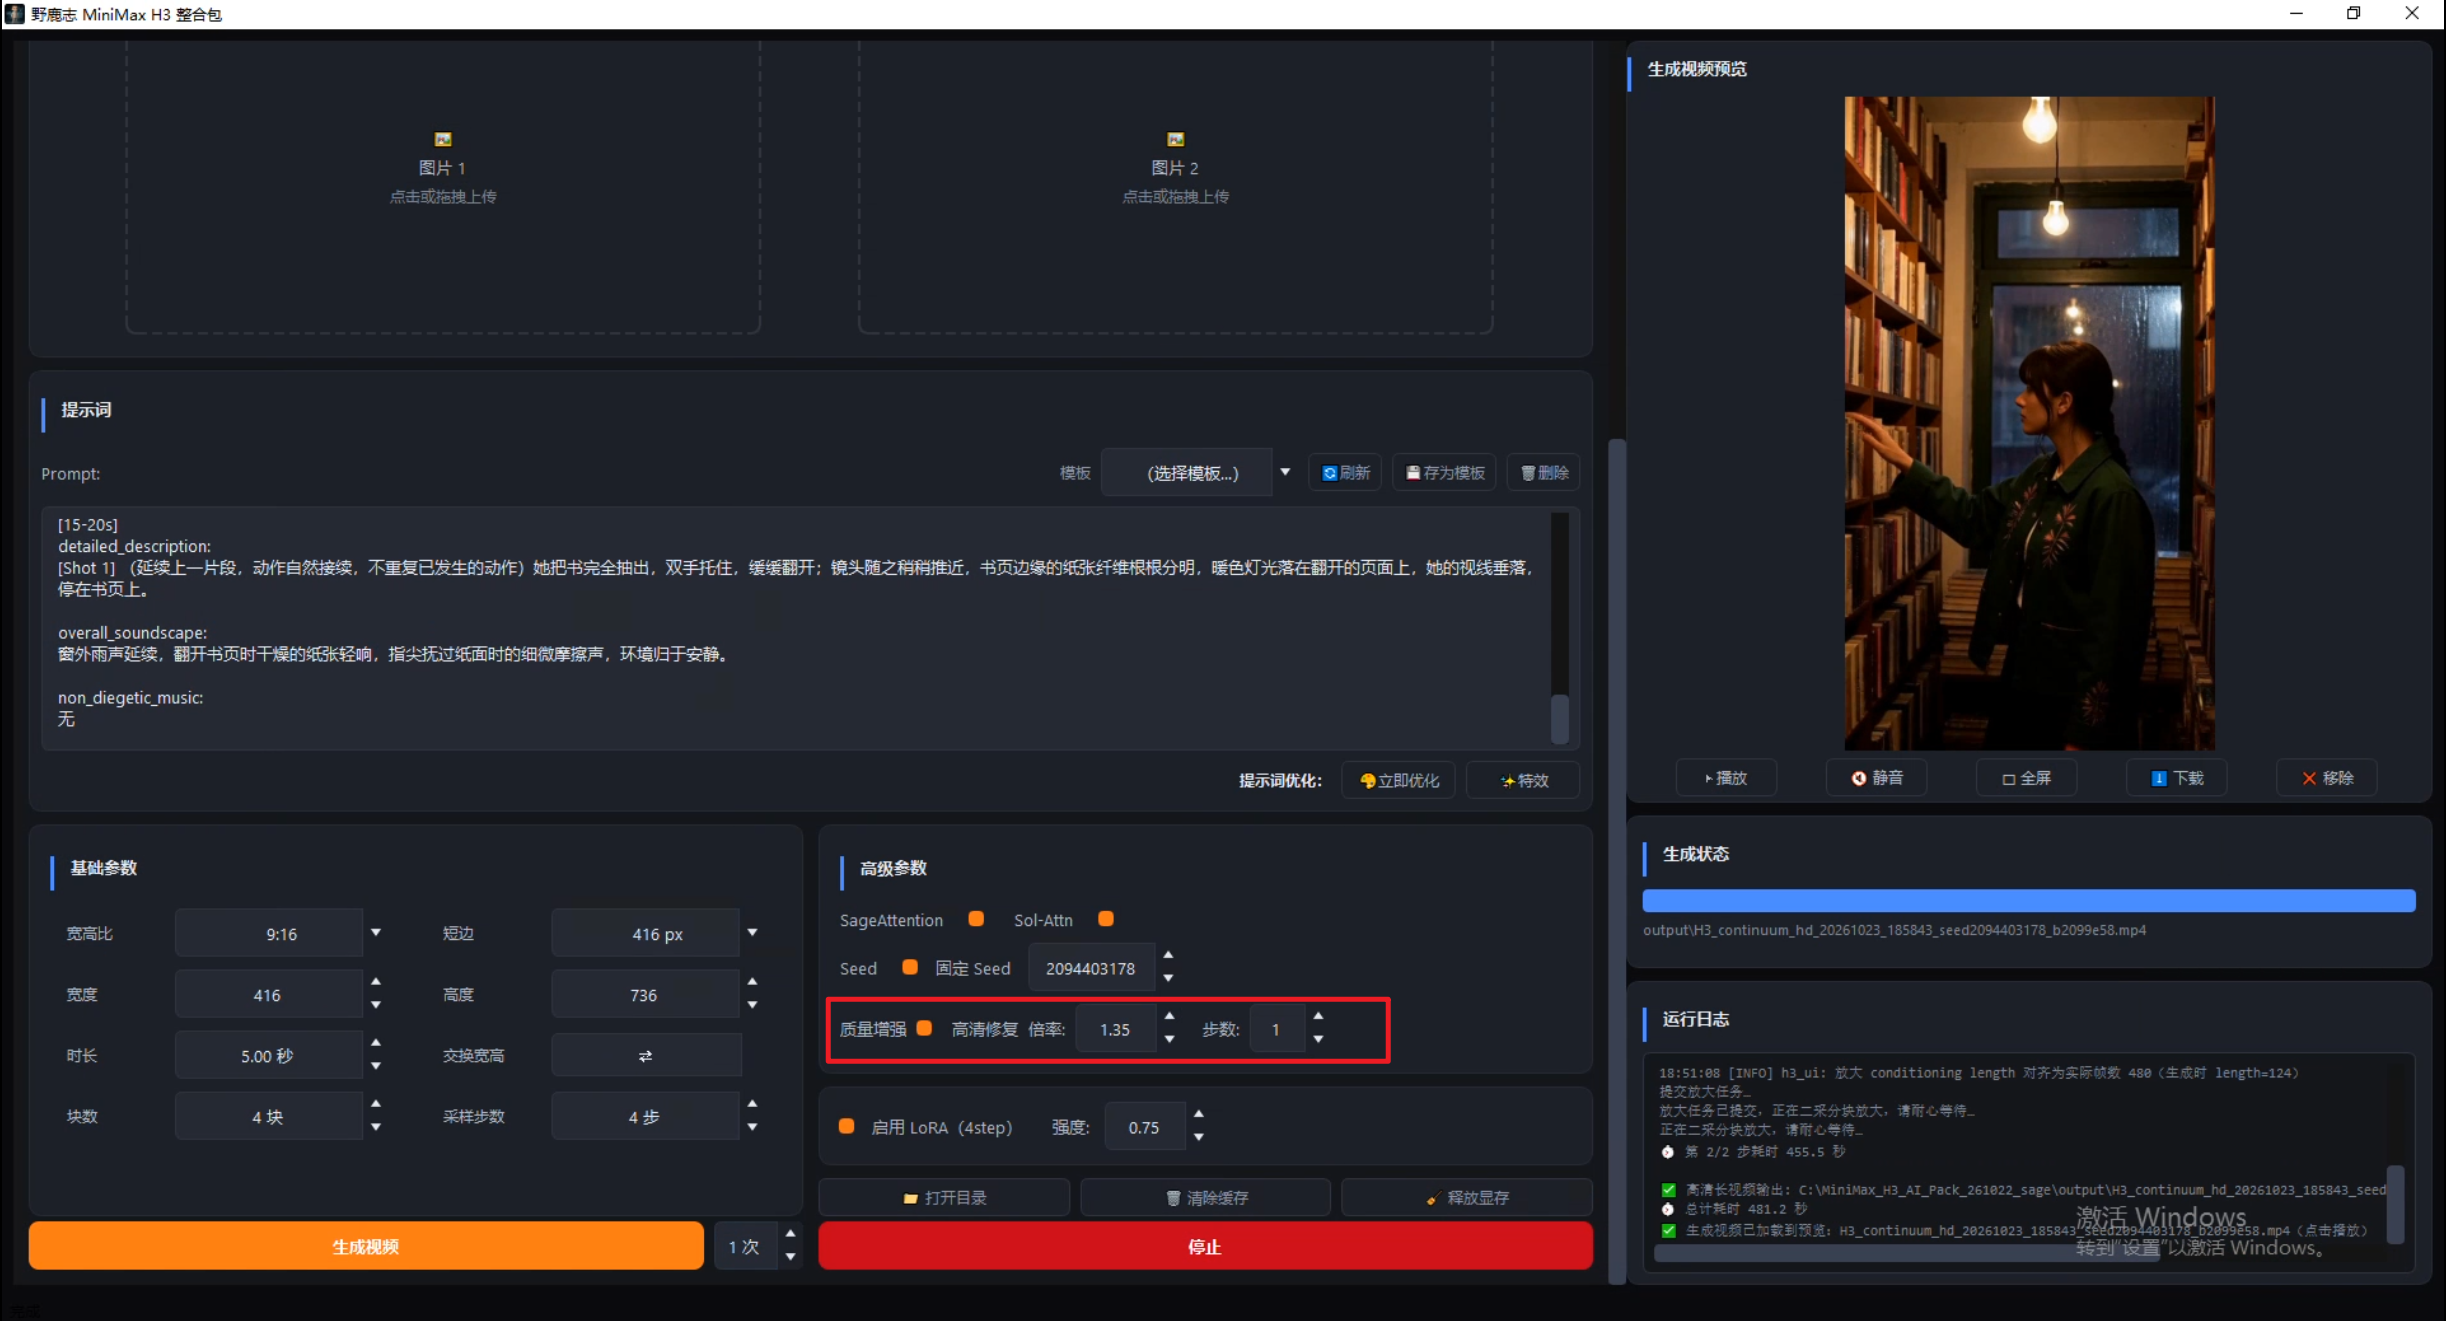
需要提醒的是,如果你在长视频模式下生成的是一镜到底的长镜头,每个分块衔接处可能会出现亮度闪烁,这是目前长视频节点已知的问题。
如果遇到这种情况,可以开启高清修复,分块衔接处的亮度闪烁问题即可解决:
长视频模式对提示词书写也有统一格式要求。我同样将官方提示词 Skill 集成到了提示词优化功能中。
当块数大于等于2时,点击提示词优化,提示词会按官方对长视频的要求进行书写:
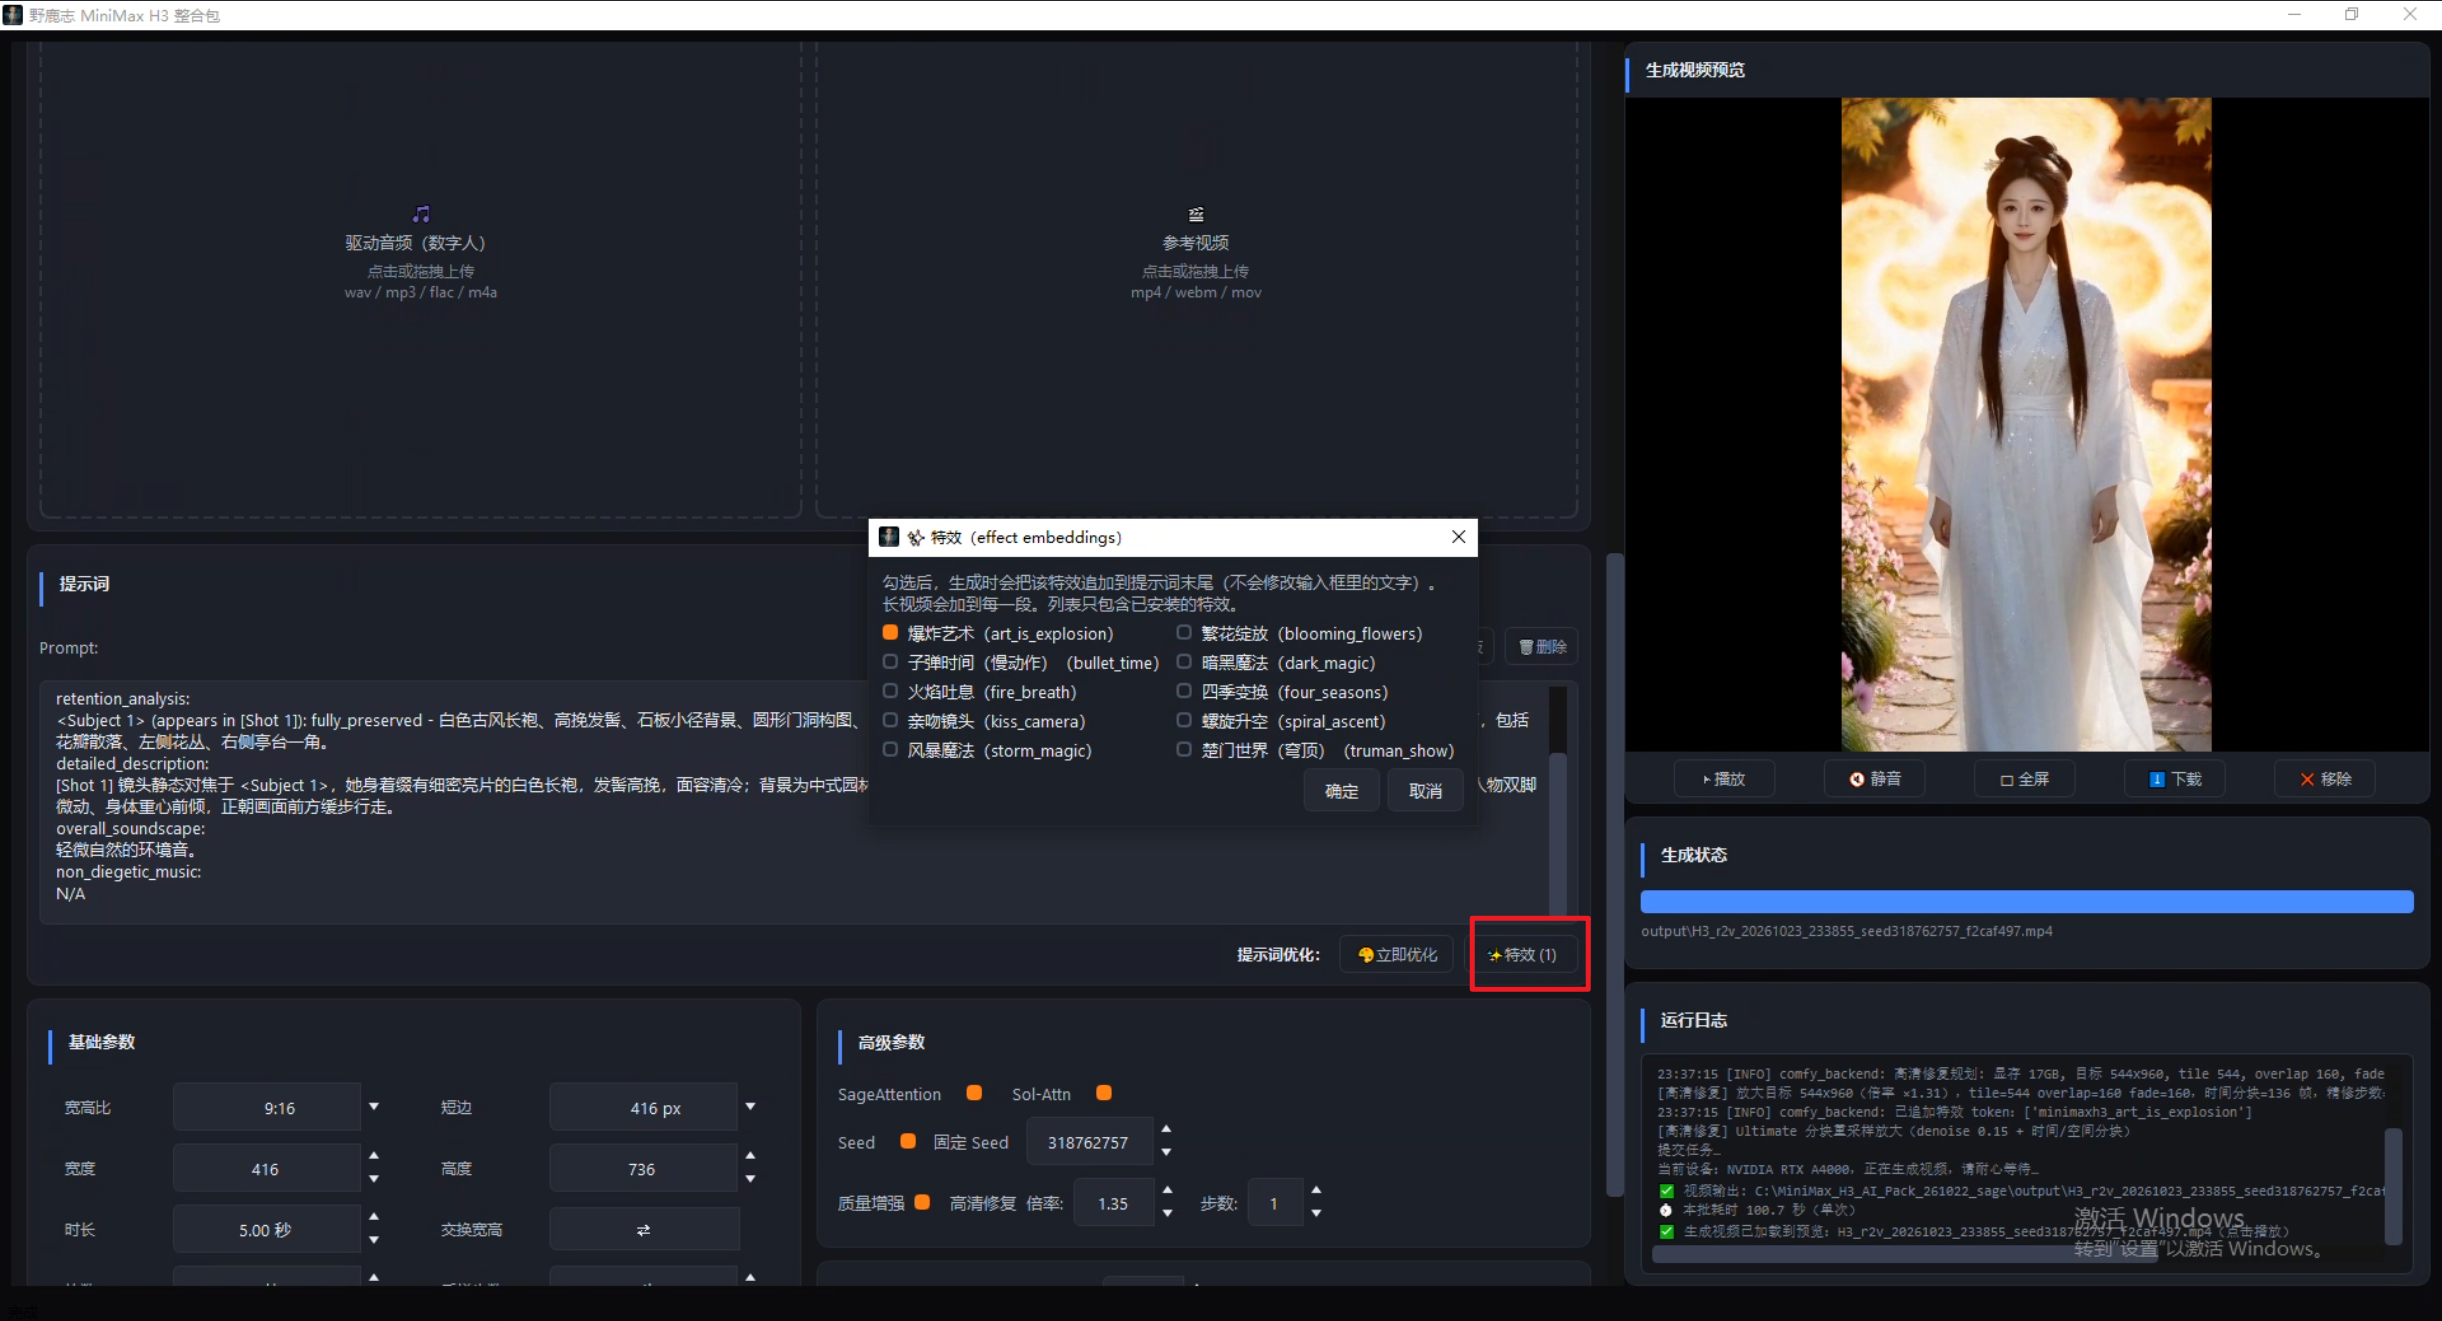
提示词优化按钮旁边有一个特效按钮,是本次新增的特效 tokens 功能,支持多选。需要提醒的是,特效 token 在所有模式(包括长视频)下都支持。
但它的本质仍是提示词。如果你上传了参考图,图像条件会与提示词争夺控制权,因此有时可能会发现特效没有生效,这时就需要抽卡:
好了,今天要分享的内容就到这里,想要整合包的鹿友
后台撩我
获取。