这段时间我只做了一件事:给 YuE2 做一个真正好用的家。
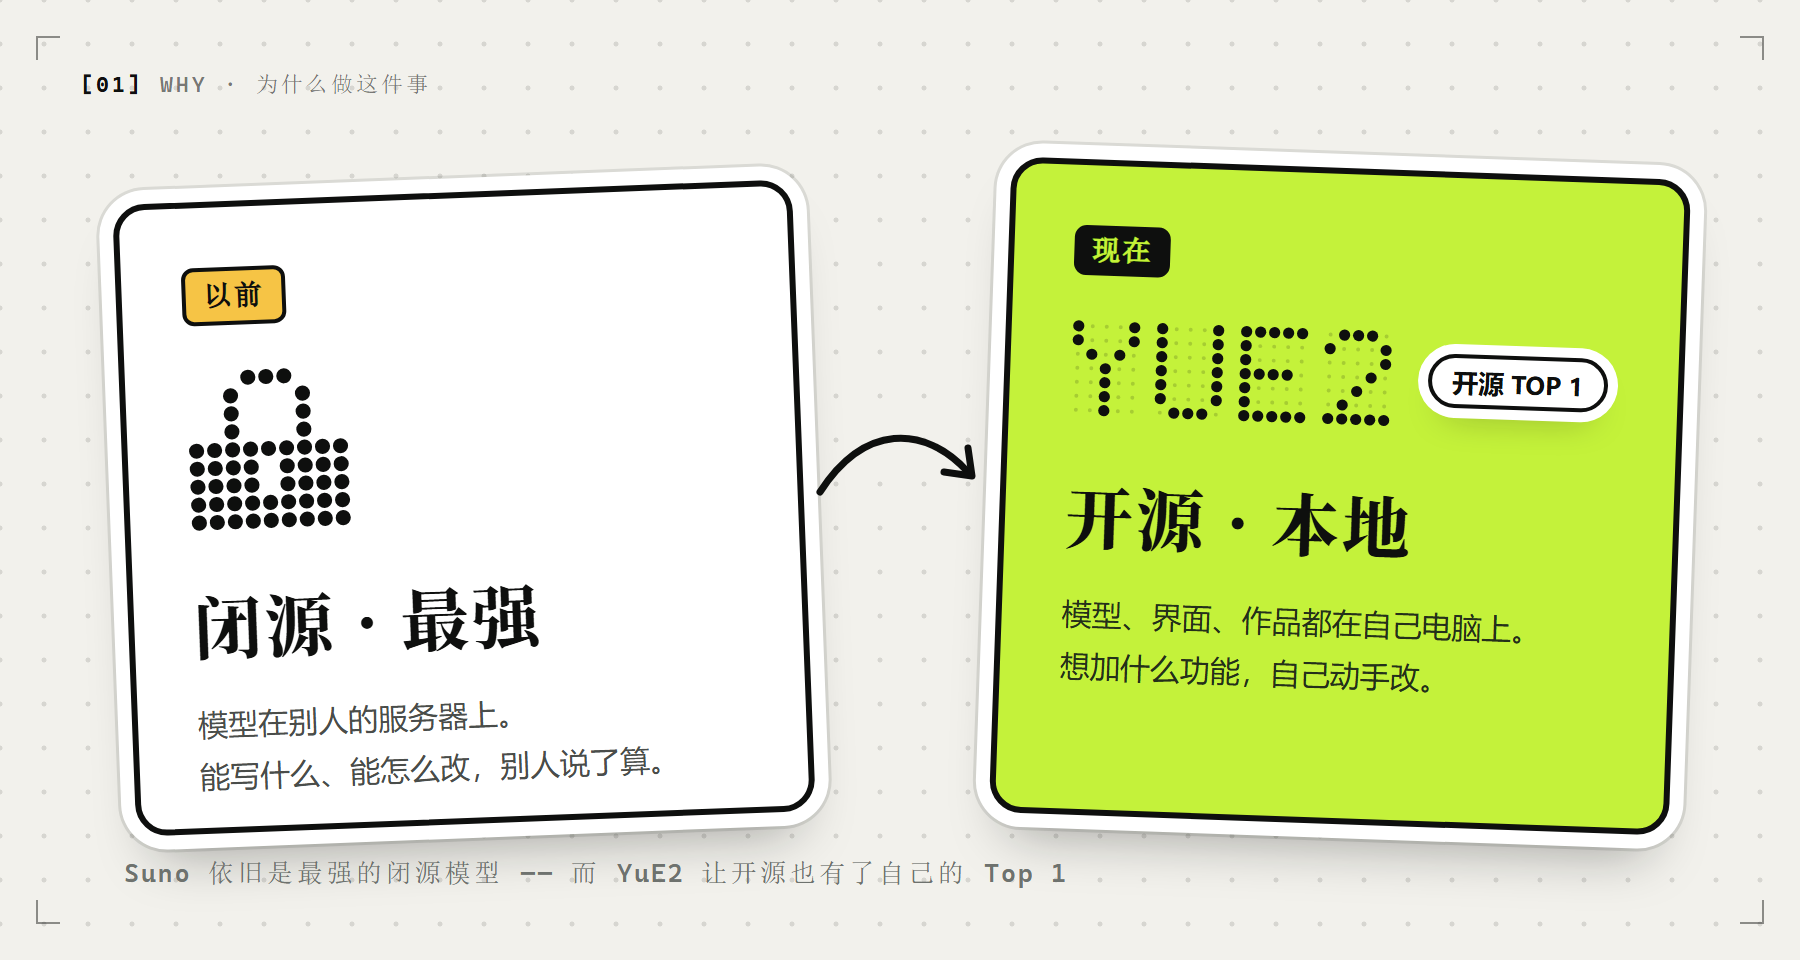
但很长一段时间里,想用 AI 写一首完整的歌,我们几乎只能打开 Suno。直到今天,它依旧是最强的音乐生成模型。
可它是闭源的。模型在别人的服务器上,能写什么、能怎么改,都由别人决定。
前段时间,YuE2 出现了。在我看来,它让开源 AI 音乐生成第一次有了自己的 Top 1。
只是,模型强不等于好用。命令行、配置文件、一屏参数——这不是写歌该有的样子。所以我给它做了一套工作台。
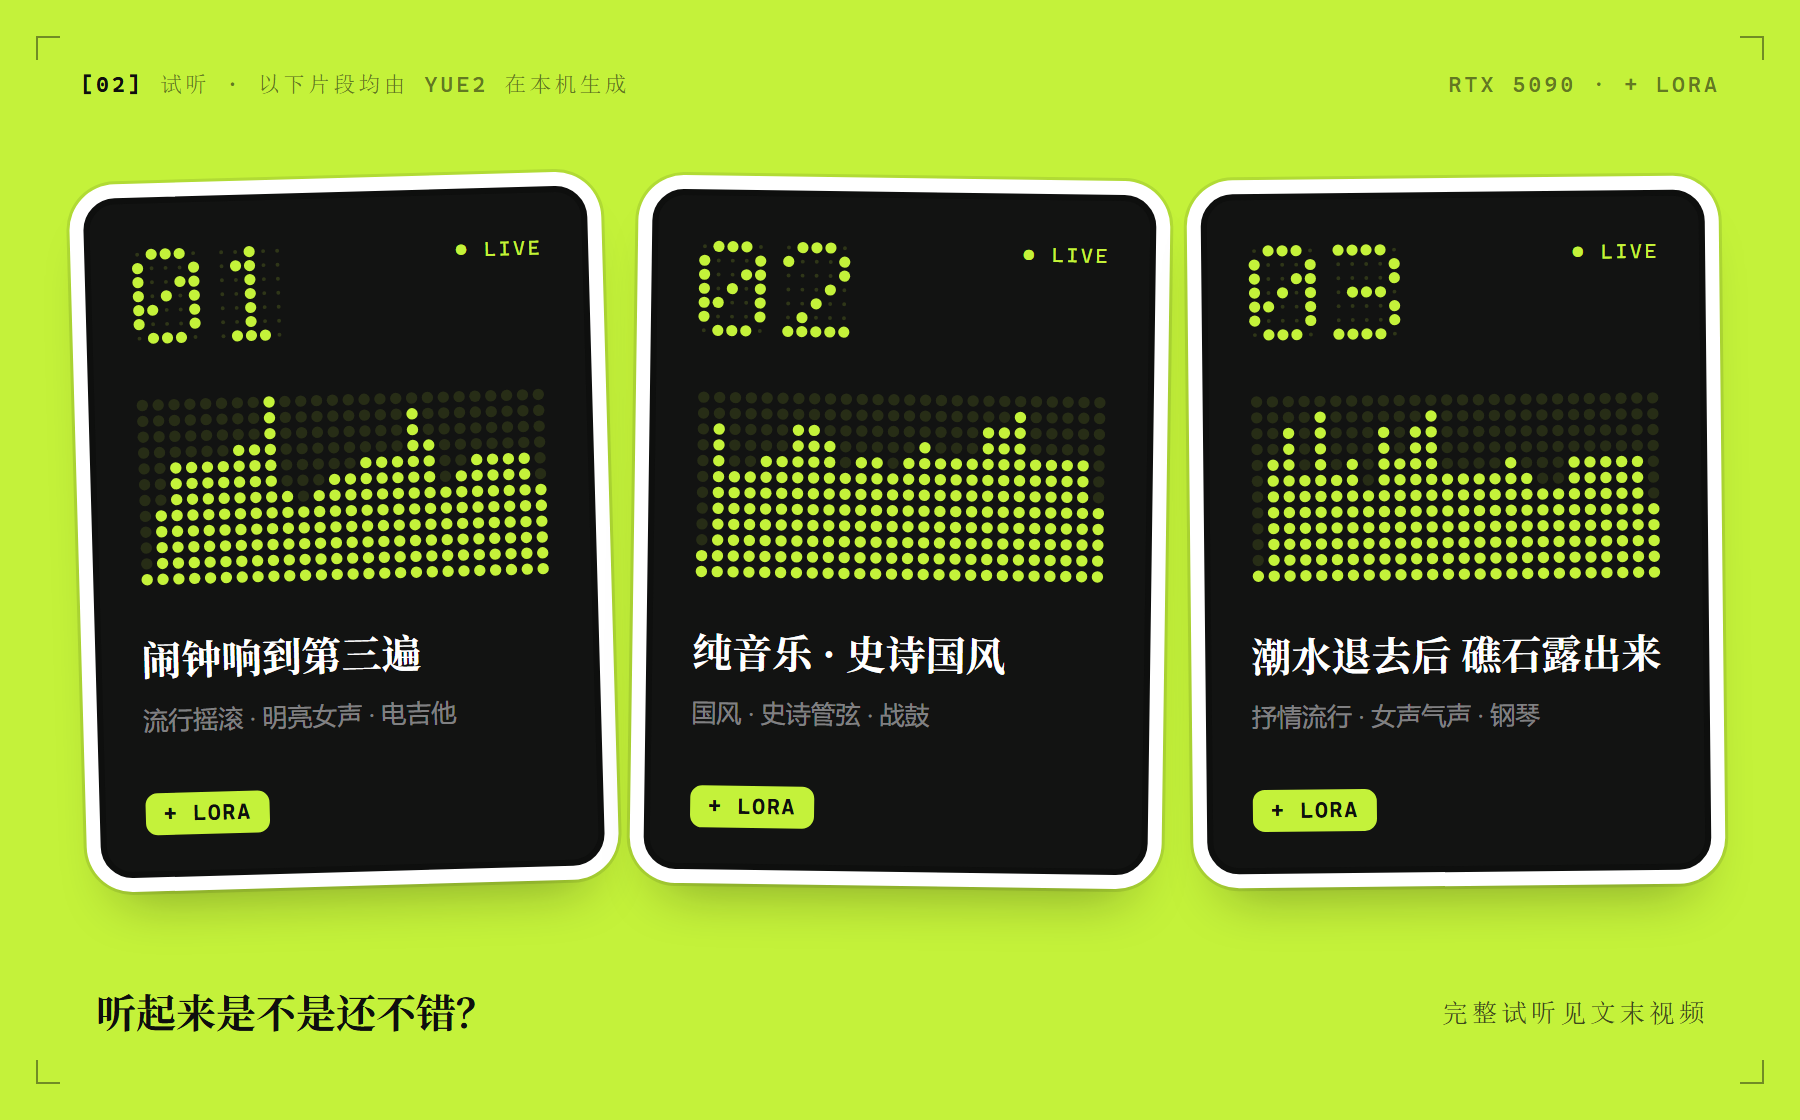
下面这两首歌,全部是 YuE2 在我本机生成的,大家可以听听看:
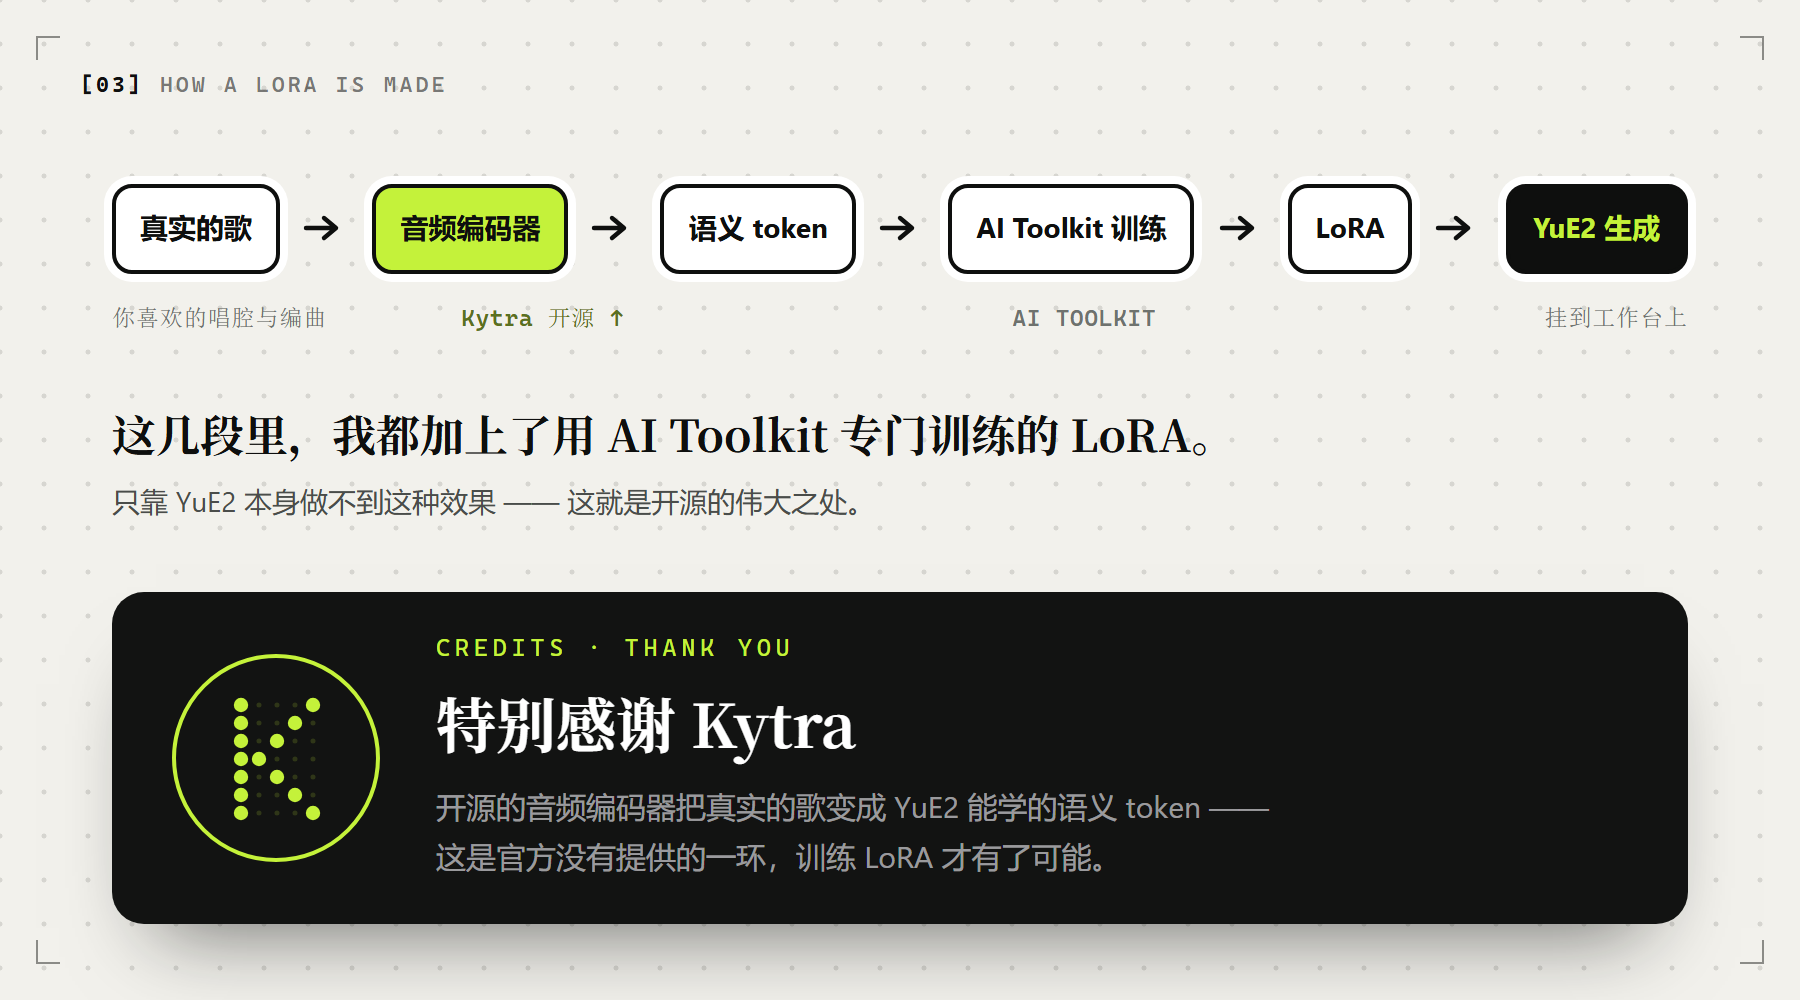
这几段里,我都加上了用 AI Toolkit 专门训练的 LoRA。
这里要特别感谢
Kytra
。是 Kytra 开源的音频编码器,把真实的歌变成了 YuE2 能学的素材,训练 LoRA 这才有了可能。
一个人搭了桥,后面的人才能过河——这就是开源的伟大之处。
当然,光有模型还不够,还要有一套配套的界面,YuE2 才能用得舒服。
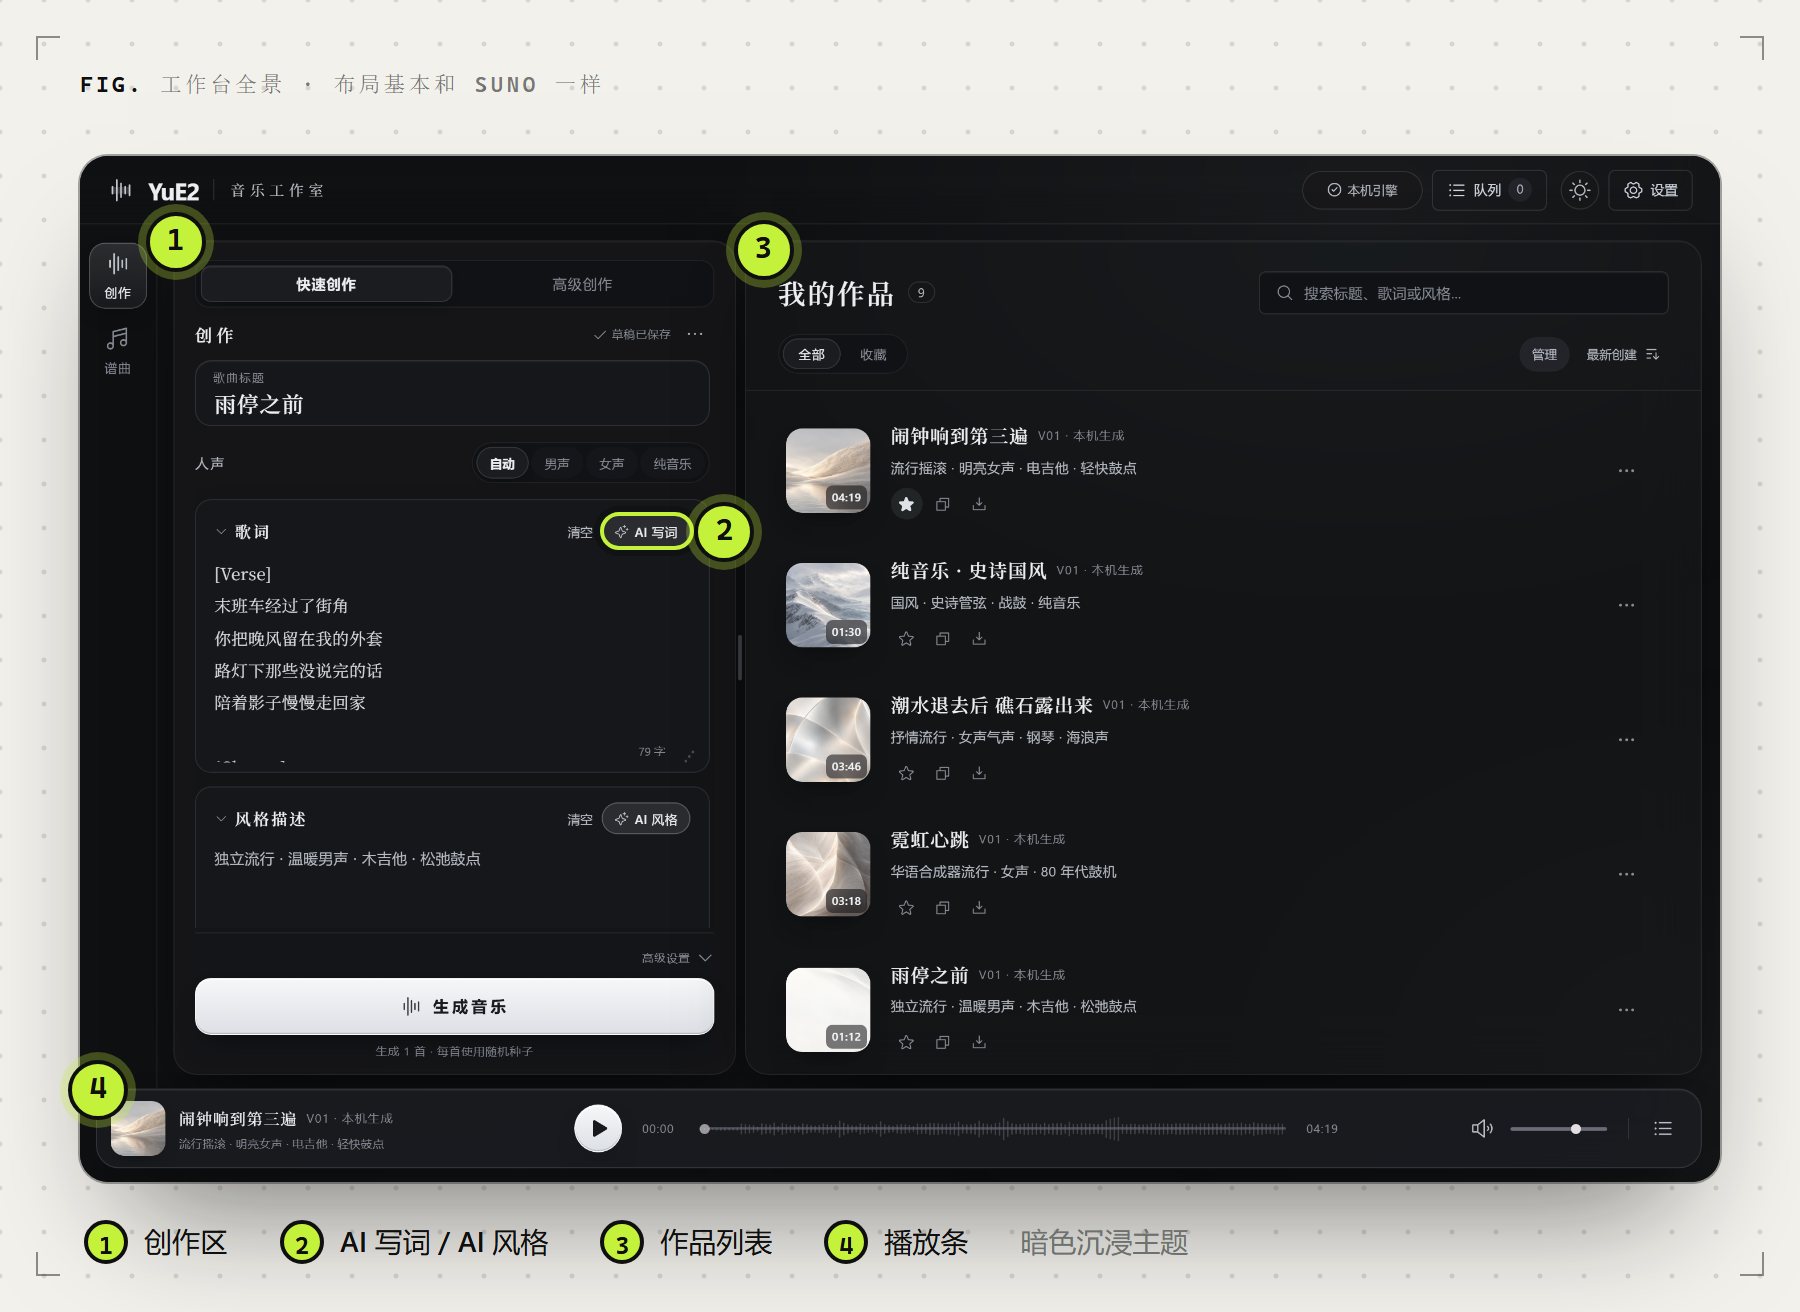
布局我基本参照了 Suno:左边创作,右边作品,底部播放条。在 Suno 上养成的习惯,到这里不用重新学。
先看左边的创作区。标题、歌词、风格,三个框就够了。
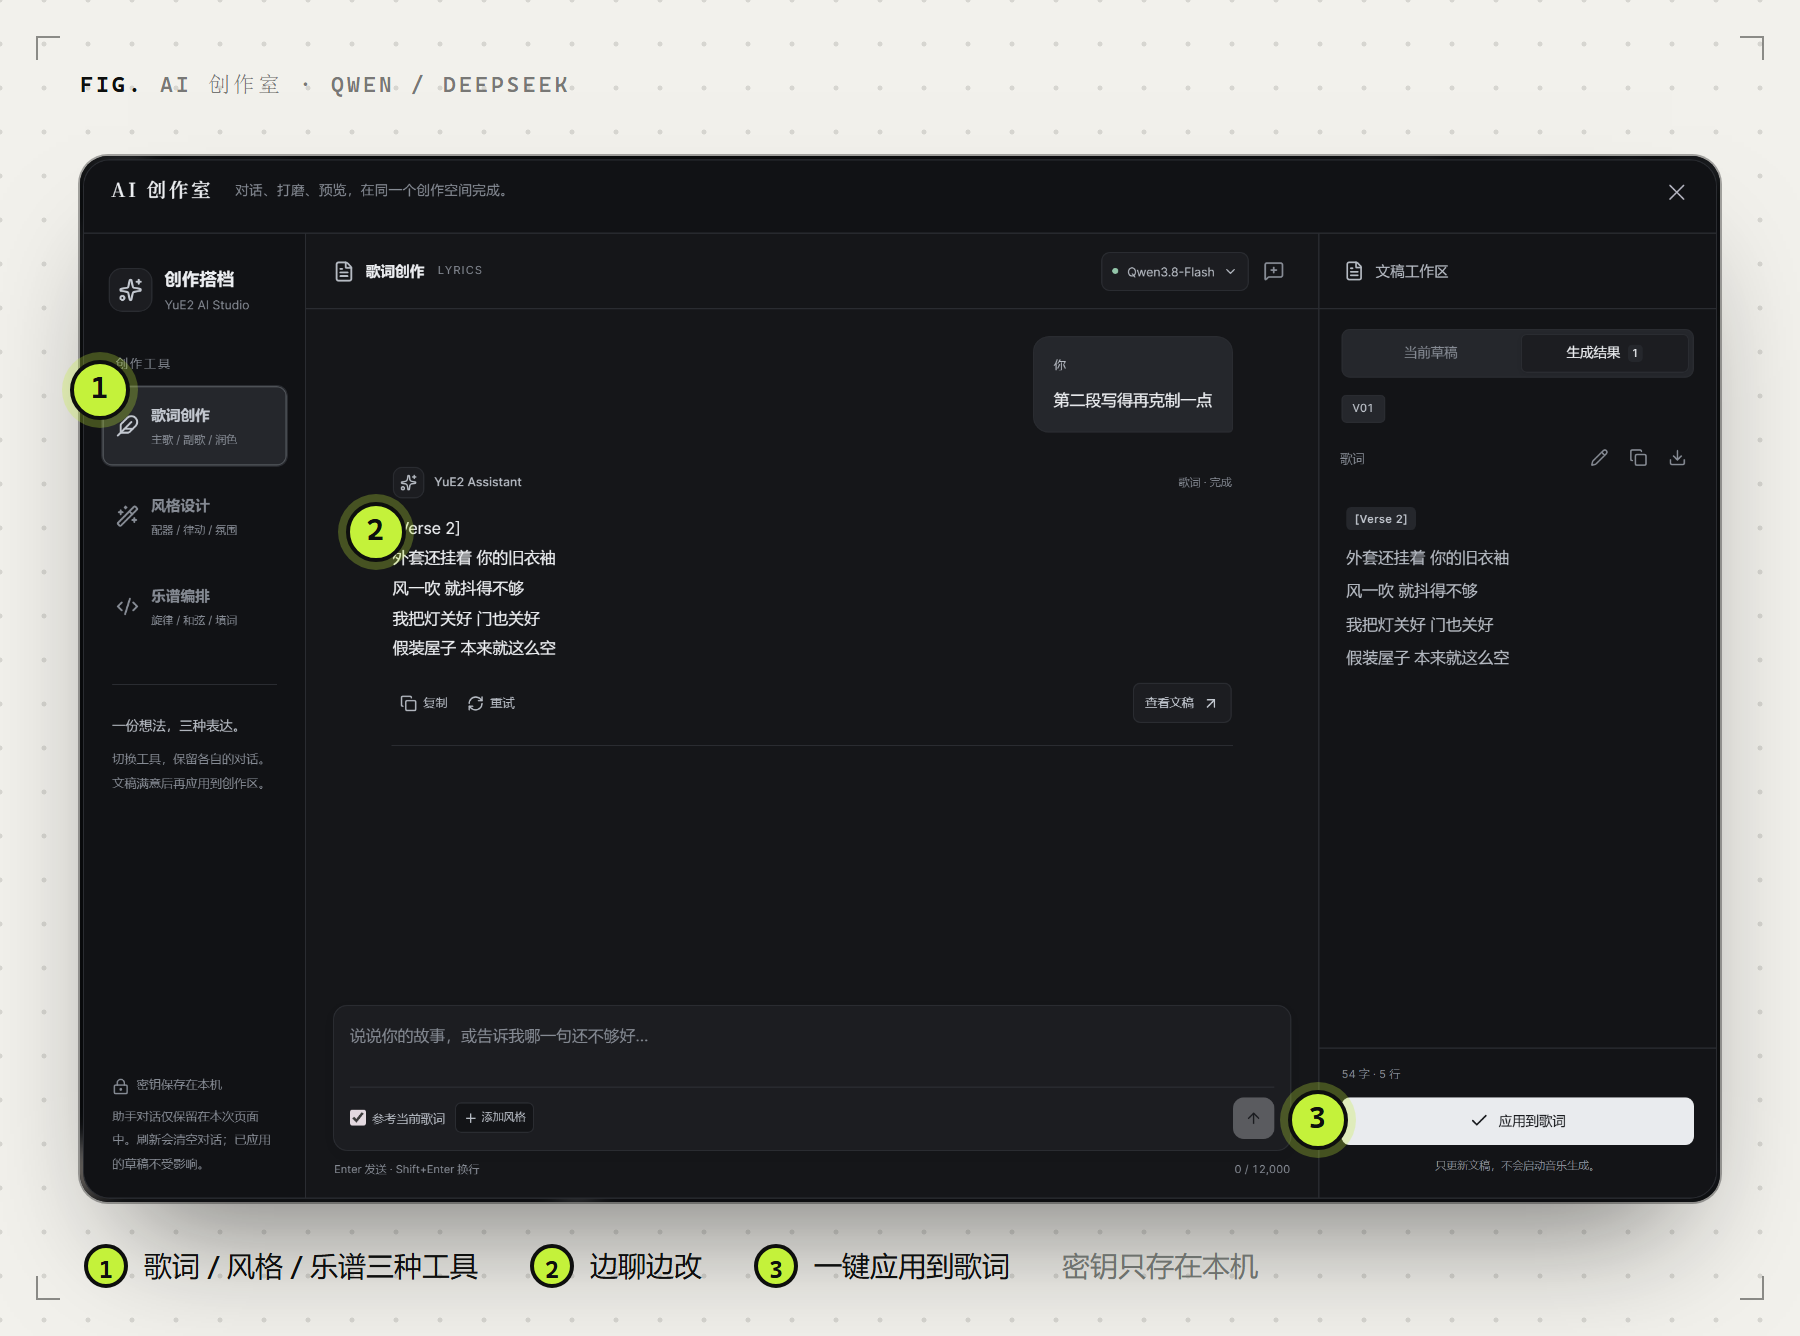
歌词没思路,就点「AI 写词」。右边会打开 AI 创作室,选 Qwen 或者 DeepSeek,填上你自己的 API Key 就能用。
边聊边改,写好的歌词和风格一键放回创作区。密钥只保存在你自己的电脑上。
人声可以选自动、男声、女声或者纯音乐。歌词留空,它就直接给你一首纯音乐。
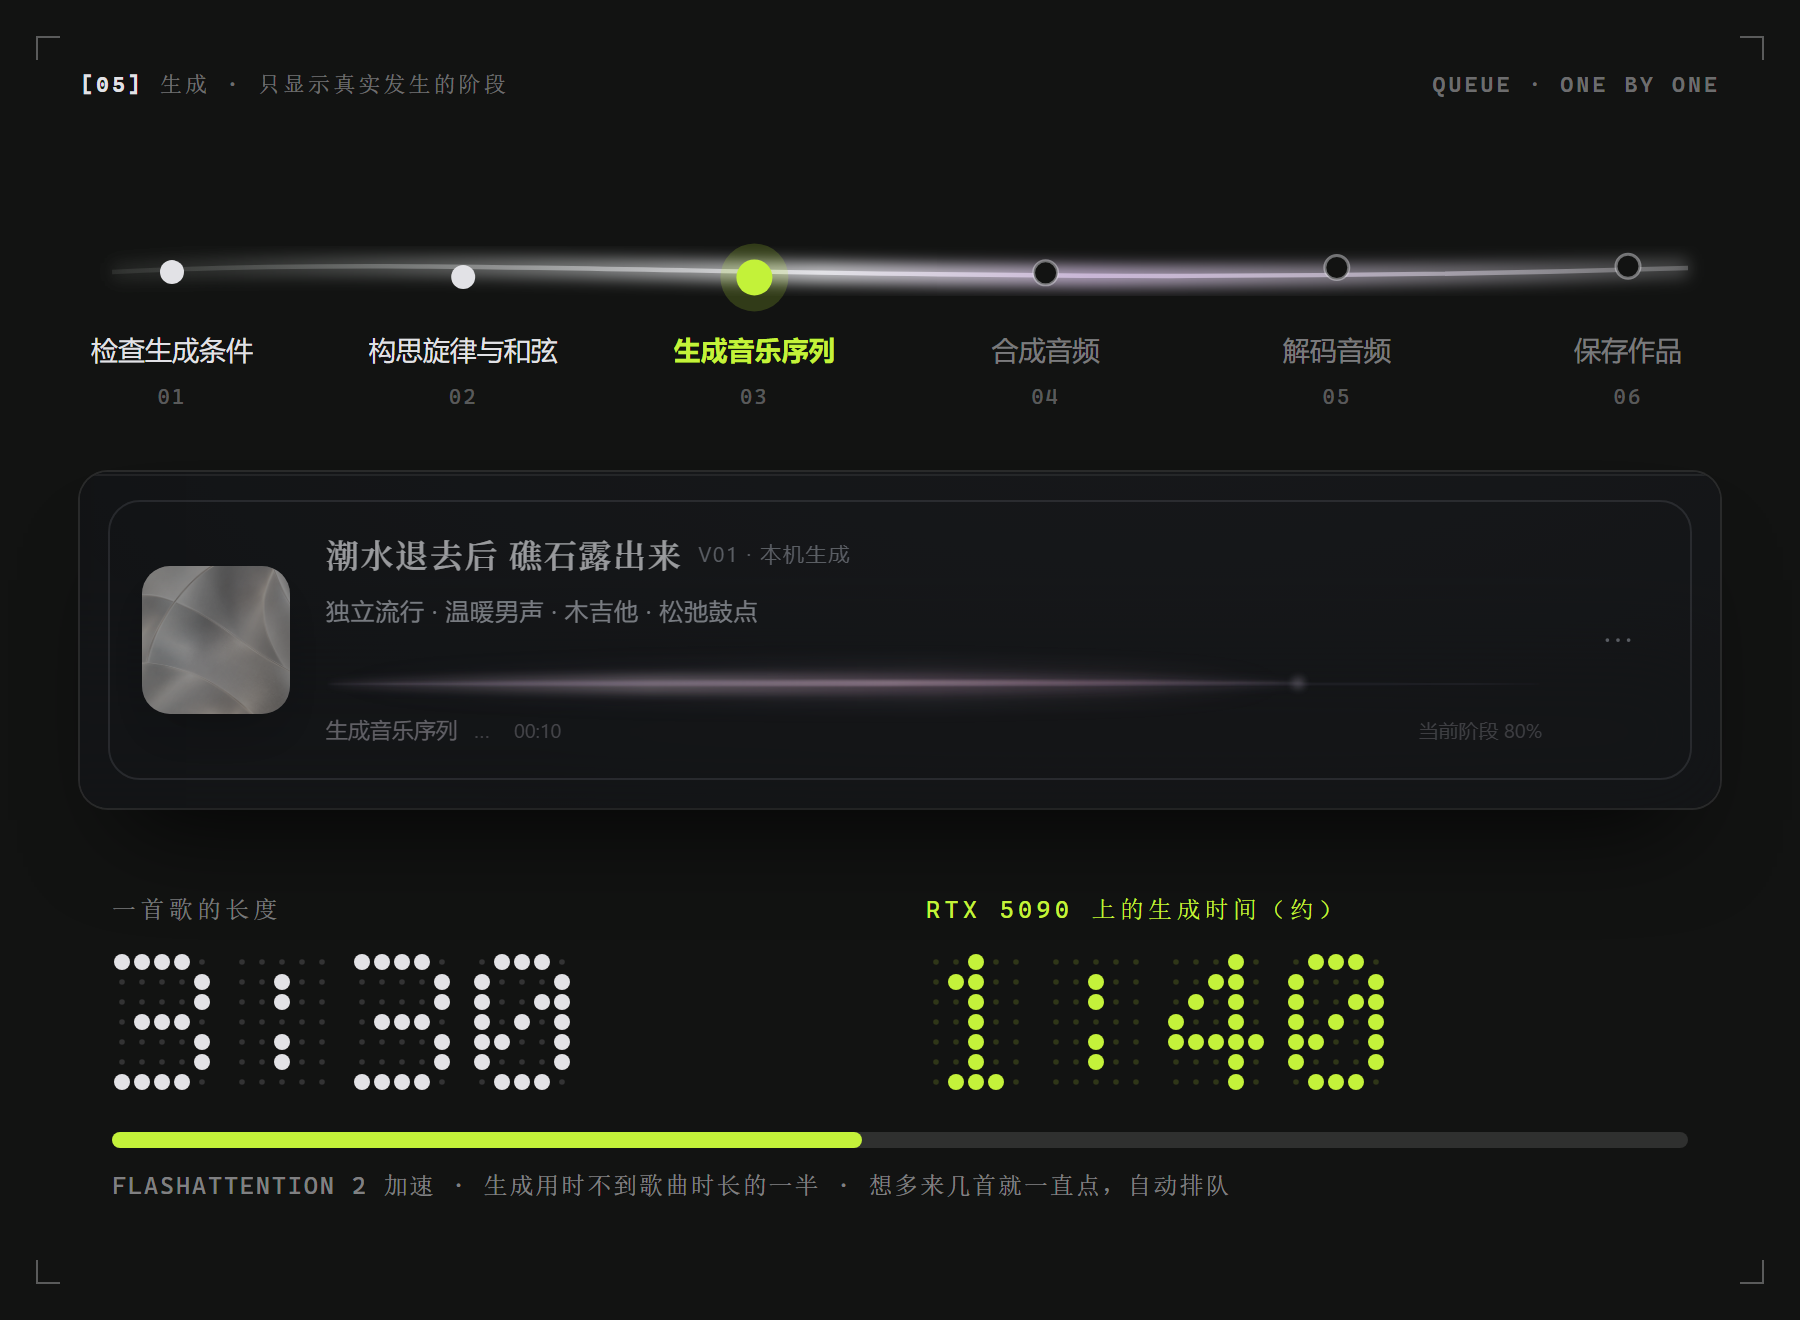
点下生成,任务就进了队列,右边会多出一张正在生成的卡片。卡片下面那条银色的丝带,就是进度。
我给它定了个规矩:
只显示真实发生的阶段
。构思旋律、生成音乐序列、合成、解码——走到哪一步就显示哪一步,不编造进度。
想多来几首就一直点,它会一首接一首地排队。我还内置了 FlashAttention 加速,在我这张 5090 上,一首三分半左右的歌,大概一分四十秒就能出来。
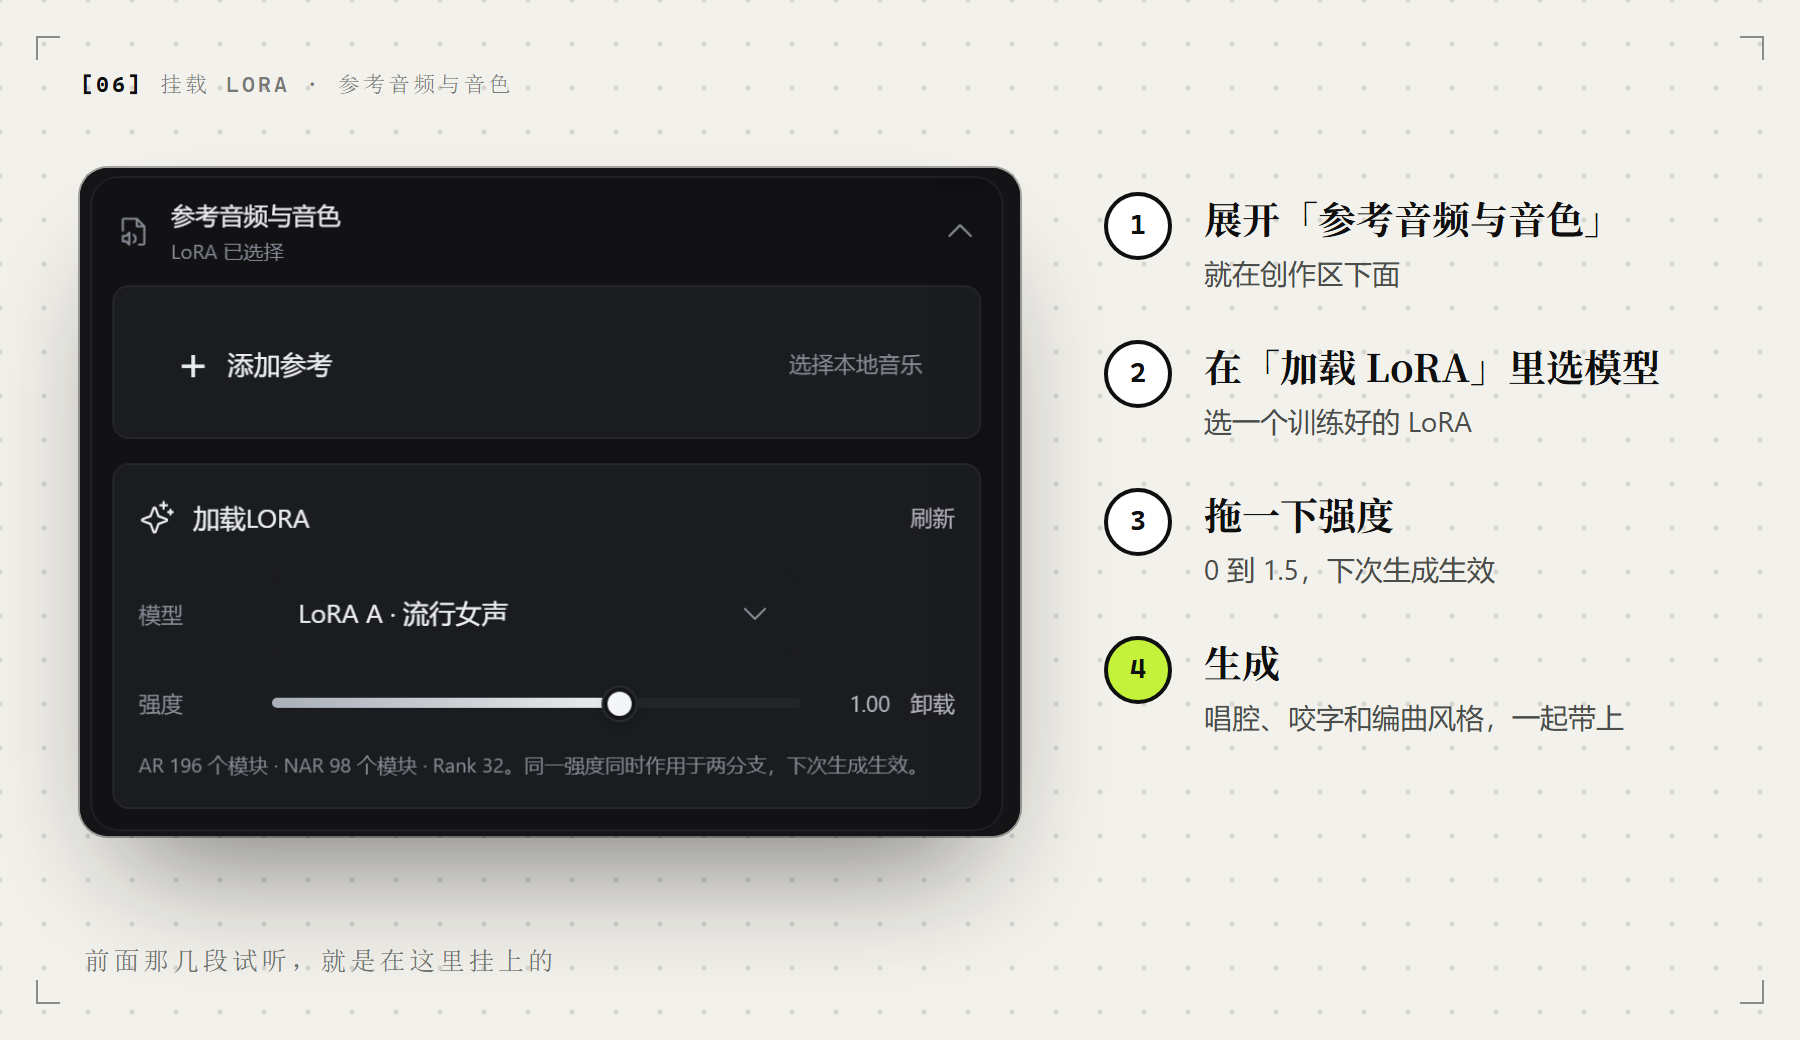
创作区下面就是 LoRA,前面那几段音乐就是在这里挂上的。
展开「参考音频与音色」,在「加载 LoRA」里选一个训练好的 LoRA,再拖一下强度。生成的歌就带上了它的唱腔、咬字和编曲风格。
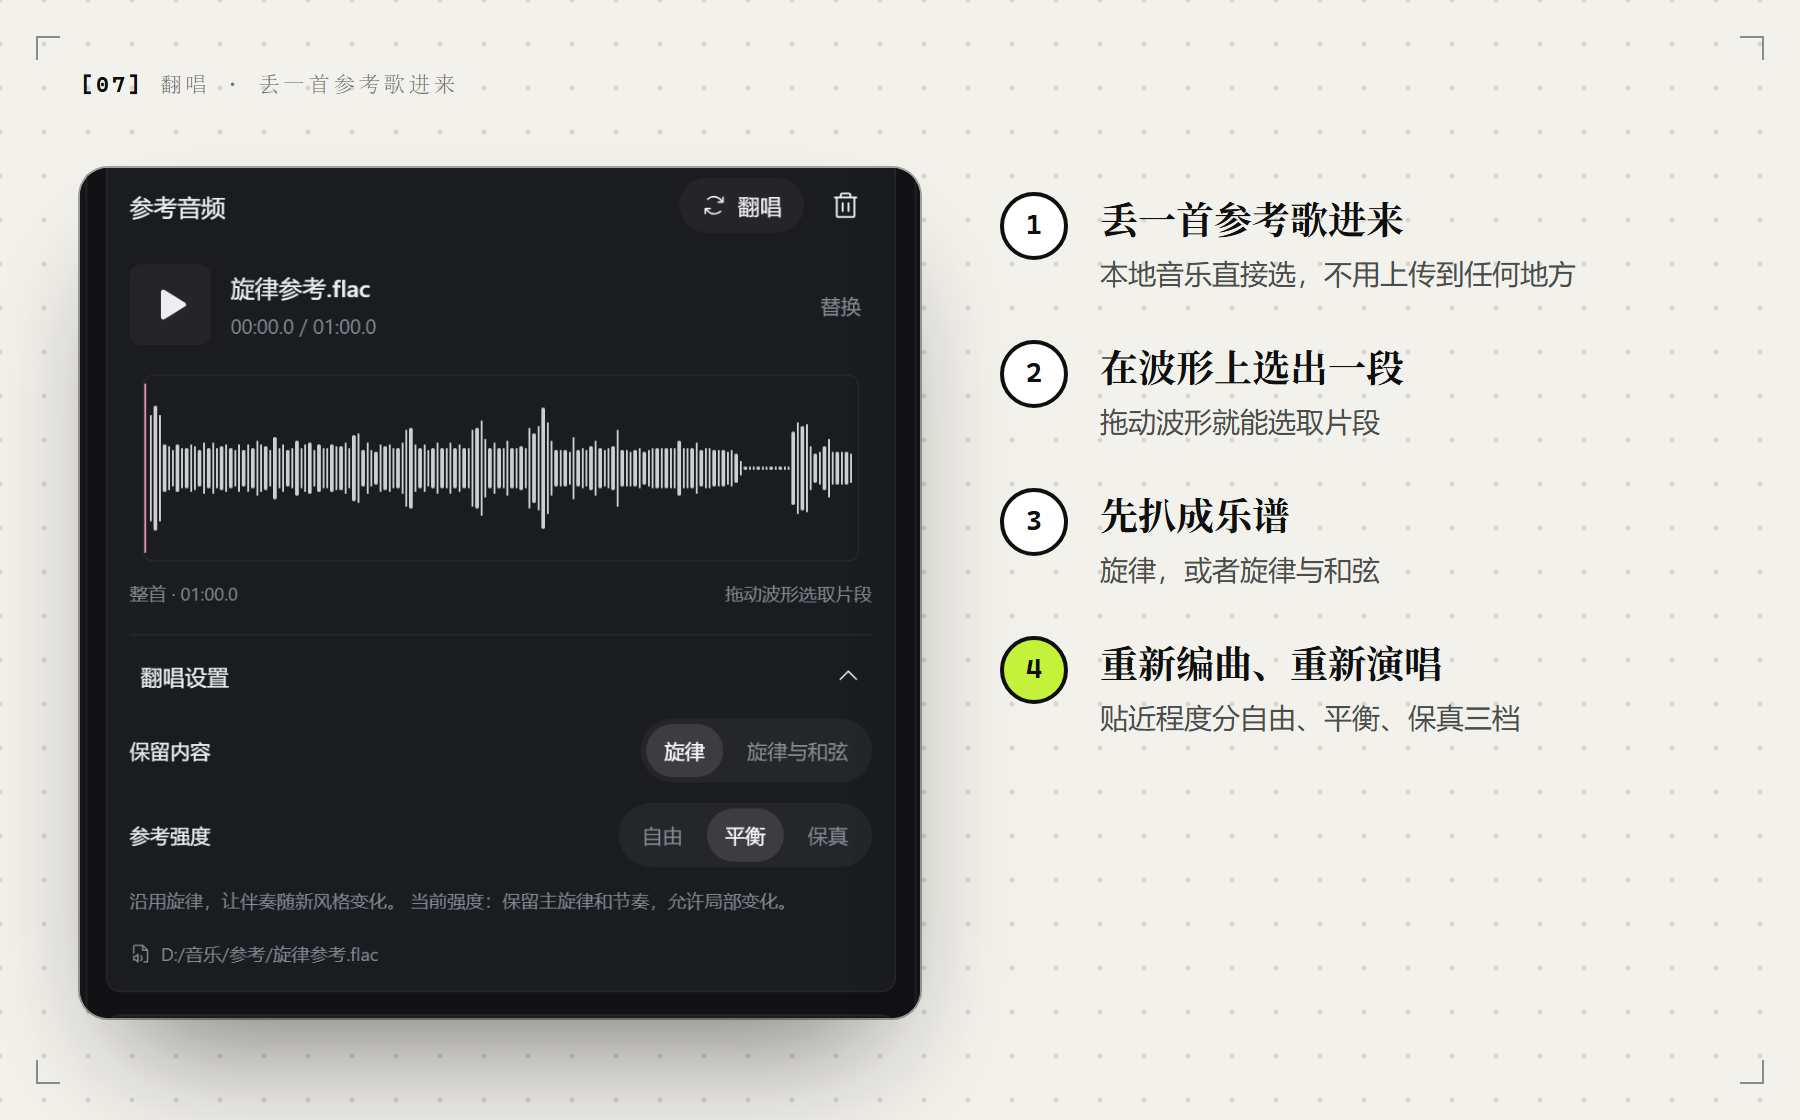
如果你心里已经有一段旋律,可以直接丢一首参考歌进来,在波形上选出一段。
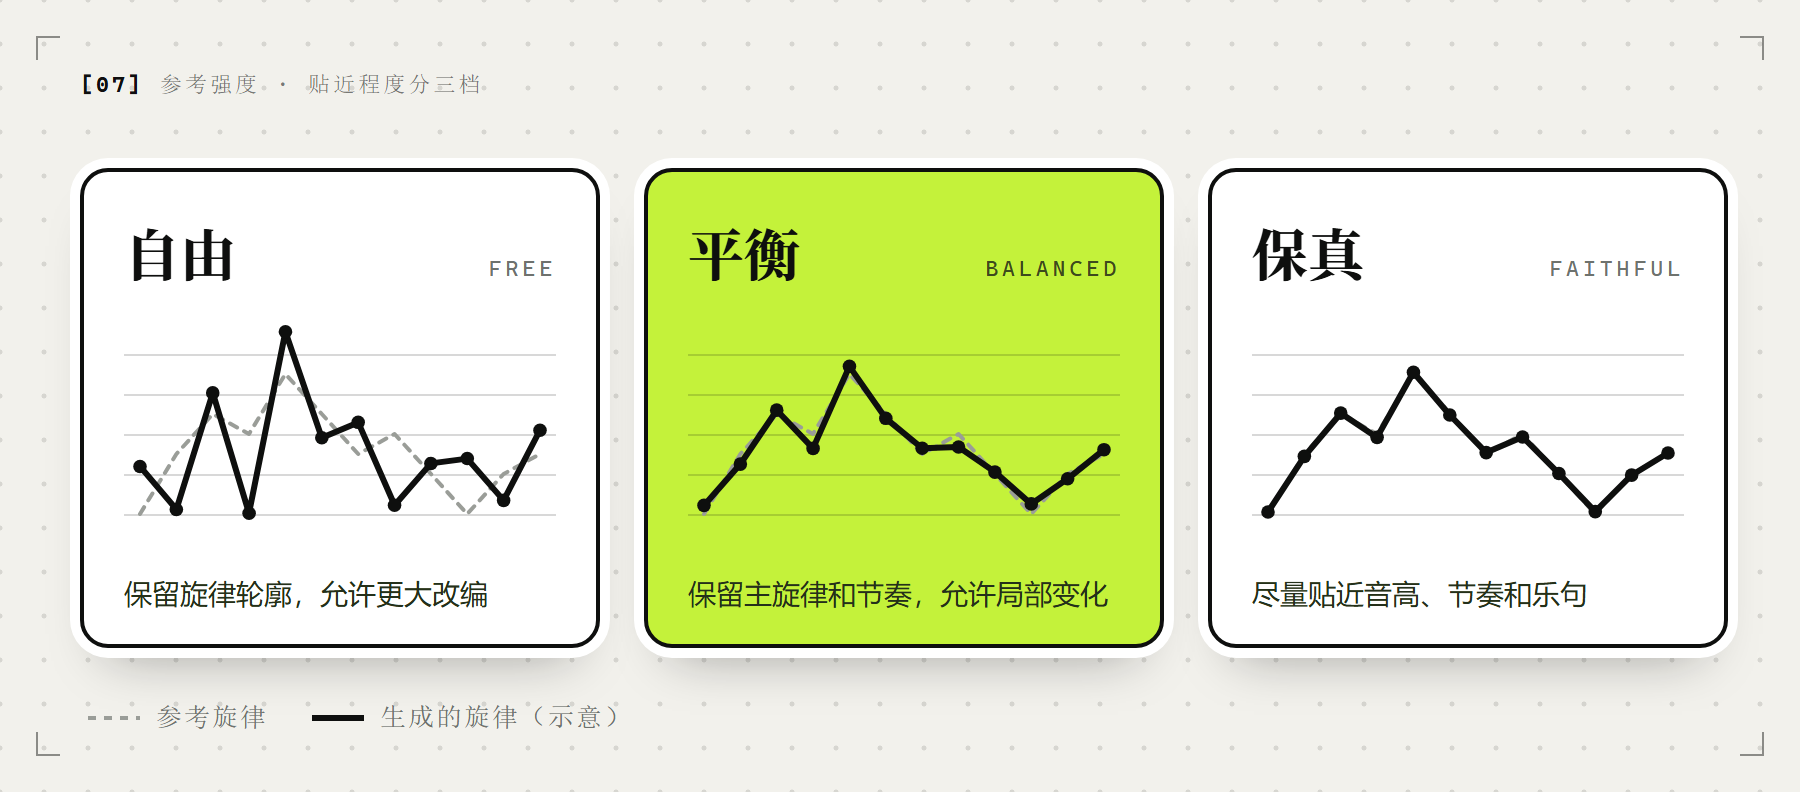
它会先把旋律扒成乐谱,再照着这段旋律重新编曲、重新演唱。贴近程度分三档:
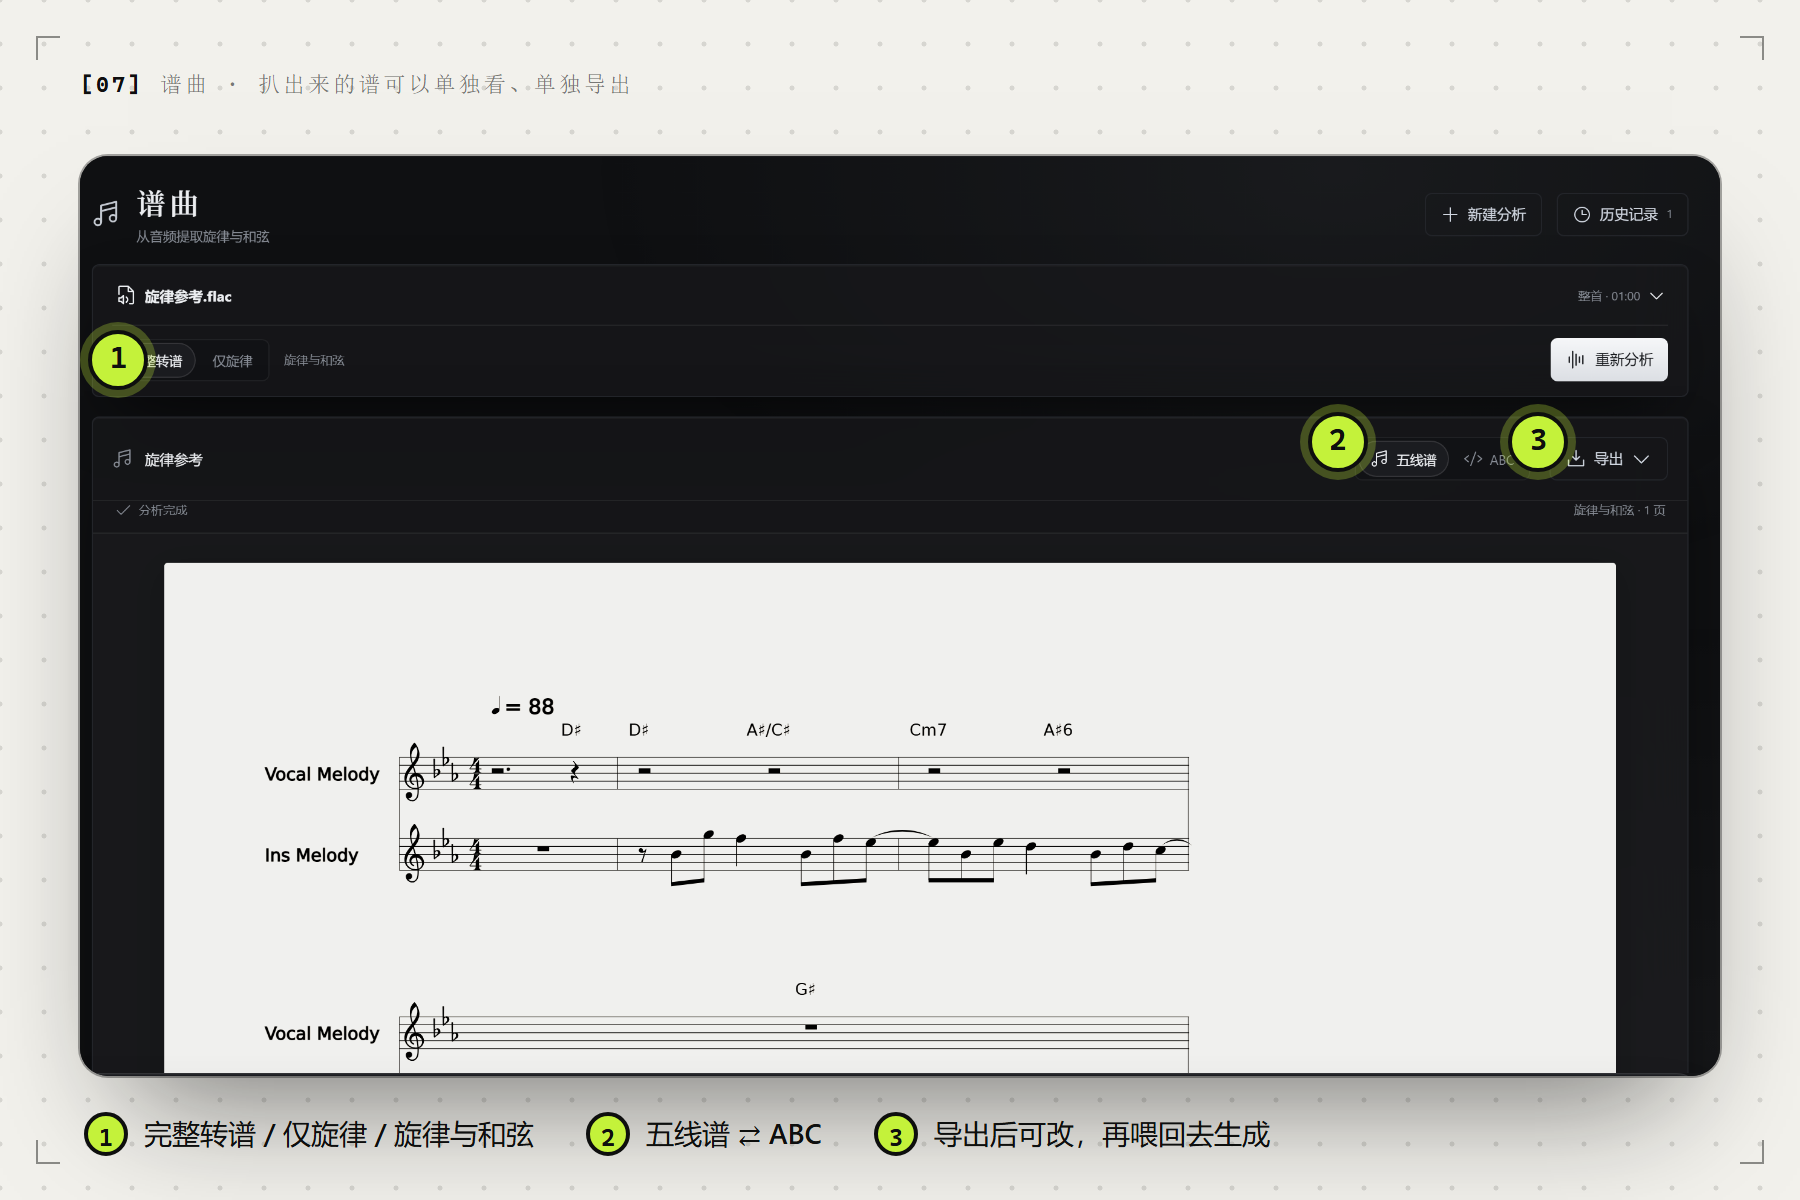
扒出来的谱也能在「谱曲」里单独看、单独导出。改好了再喂回去,让它按你的谱来生成。
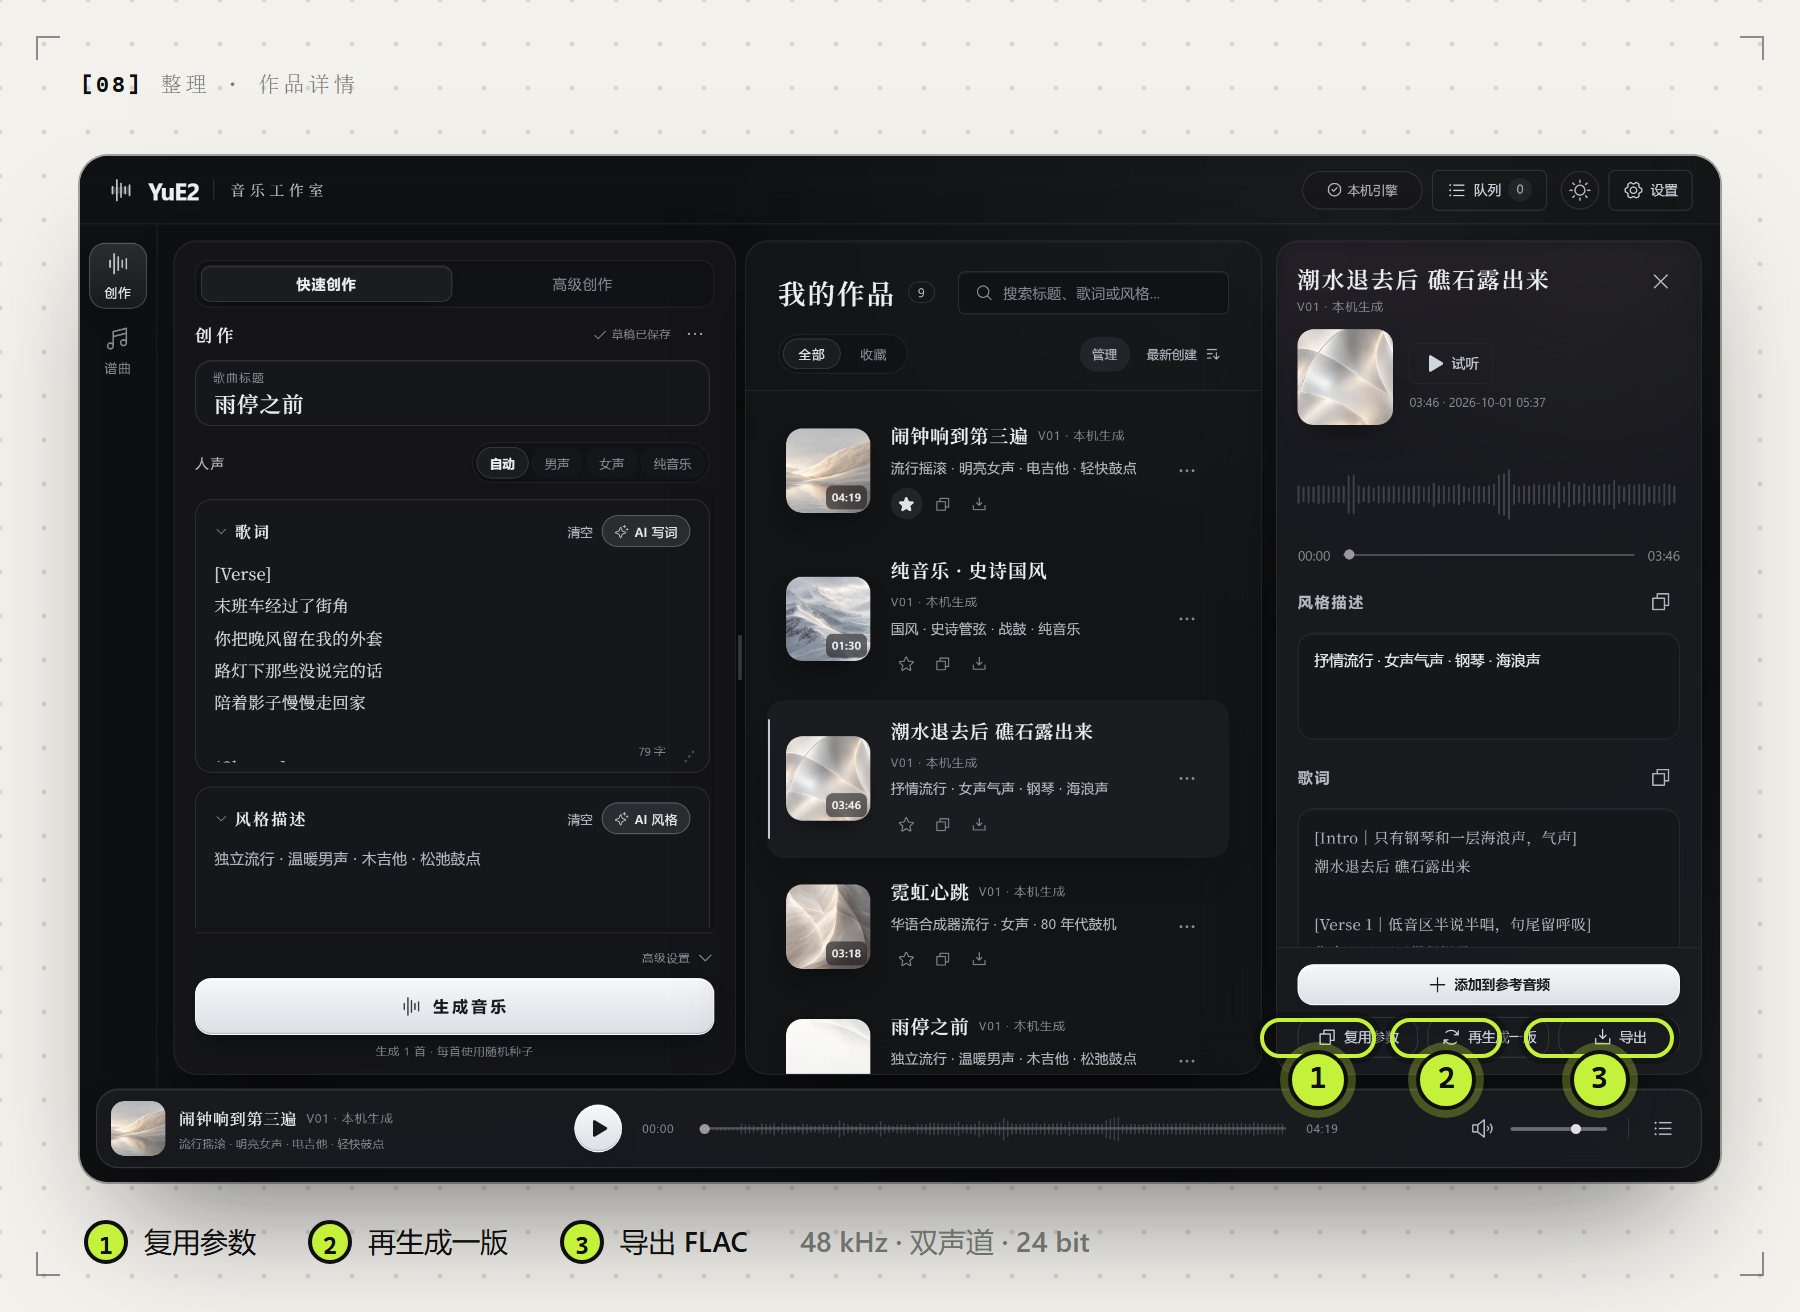
所有作品都在右边这个列表里。每一首都记着当时的参数,点一下「复用参数」就能回到当时的状态;想换个随机种子就「再生成一版」。
导出的是原始 FLAC:48 kHz、双声道、24 bit。
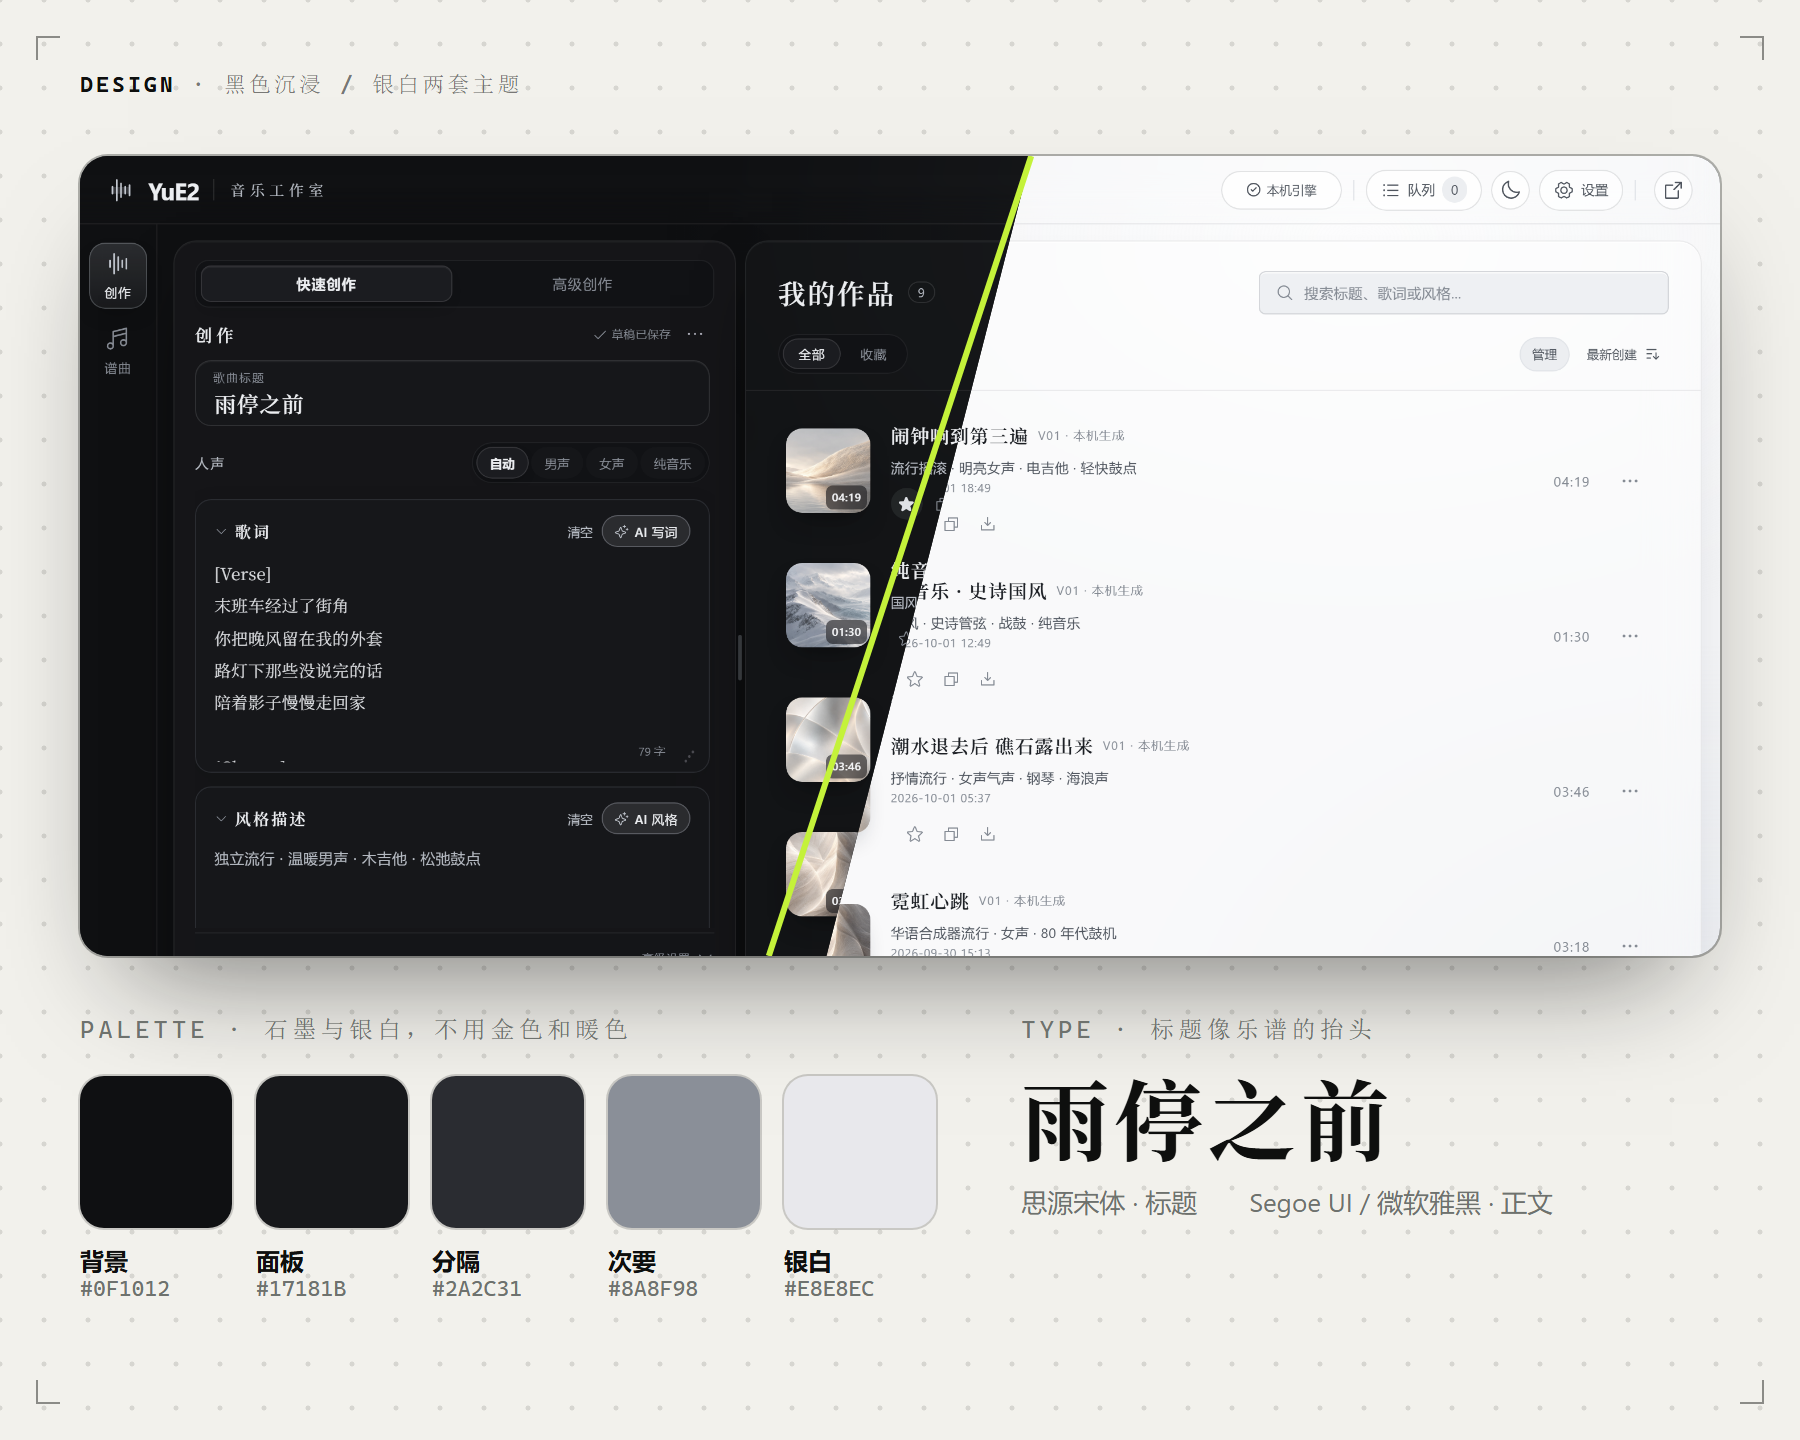
两套主题
:默认是黑色沉浸主题,右上角一键切到银白主题。配色只用石墨和银白,刻意不用金色和暖色,让作品封面成为页面里唯一有温度的东西。
字体
:标题用思源宋体,像乐谱的抬头;正文用无衬线,保证小字号下也清楚。
进度
:那条银色丝带只在真实阶段推进。等待是创作的一部分,我不想用假进度去安抚它。
布局
:沿用 Suno 用户已经熟悉的结构,把学习成本留给音乐本身。
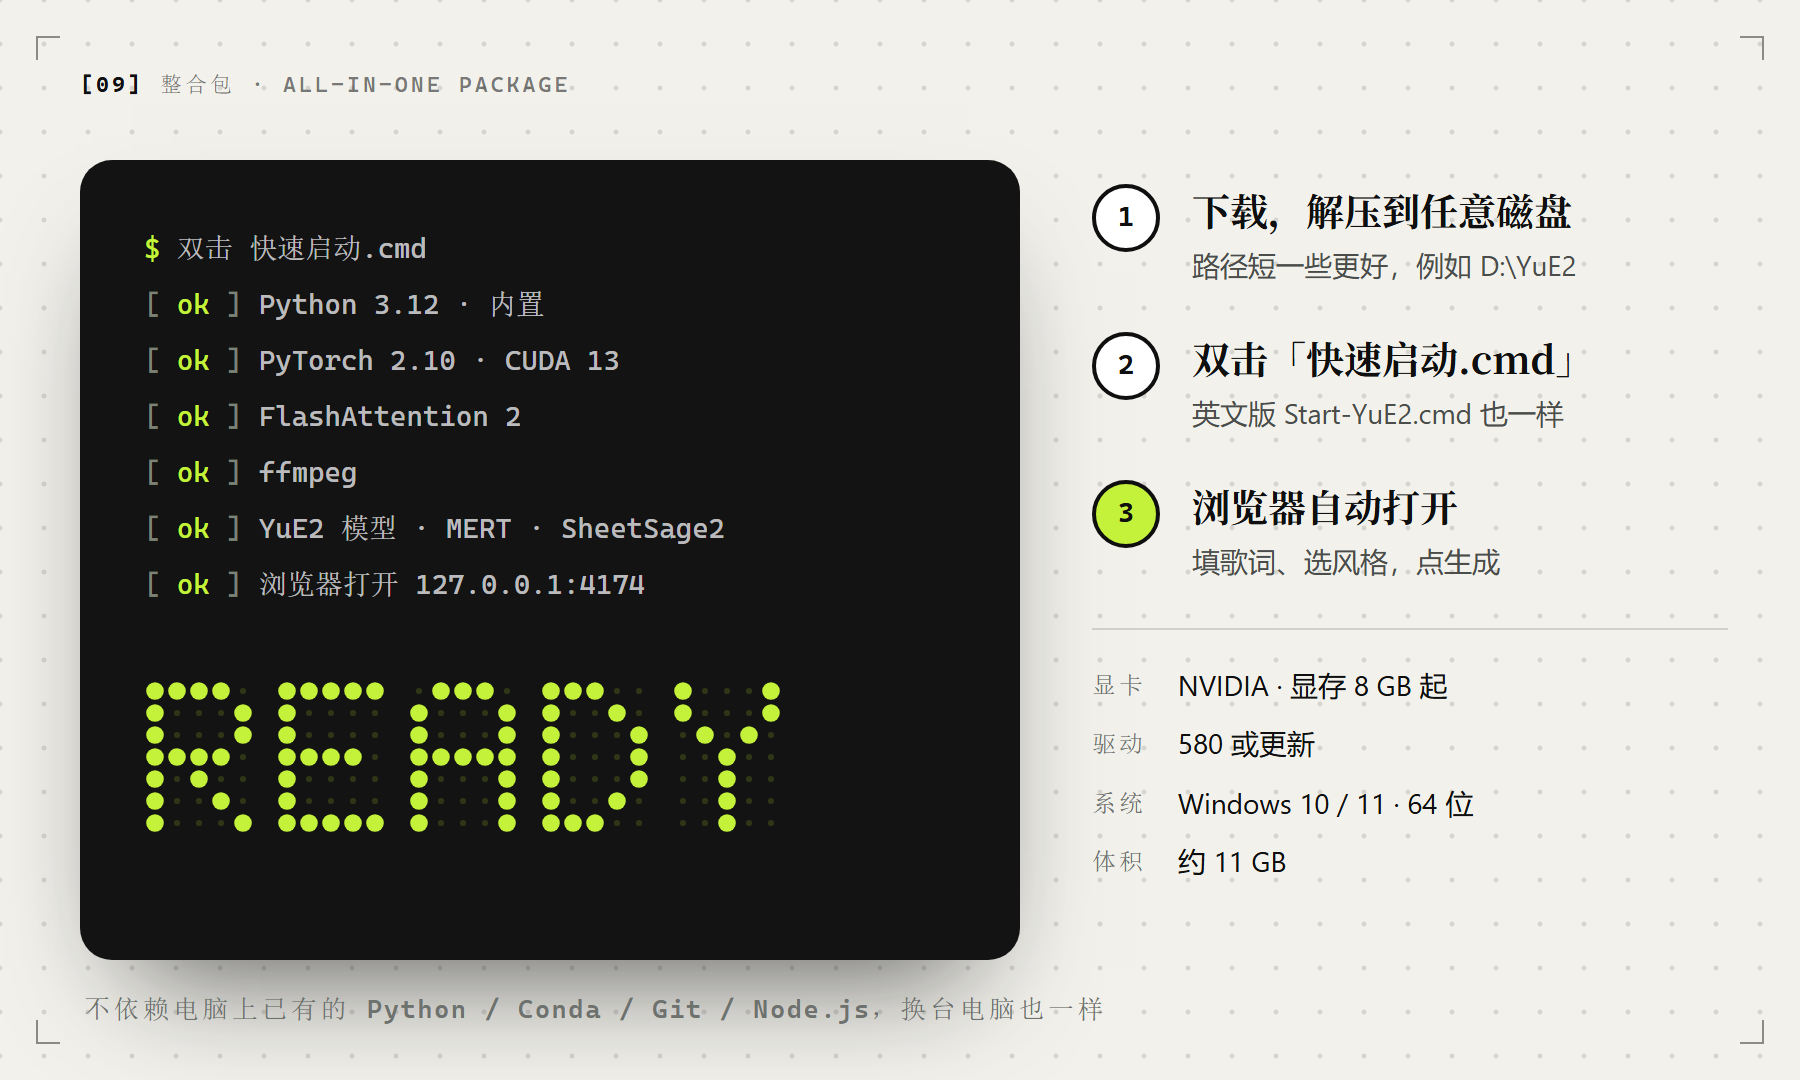
Python、PyTorch、ffmpeg 和模型都打包在里面,不依赖你电脑上已有的任何环境,也不用装 Conda、Git 或 Node.js。
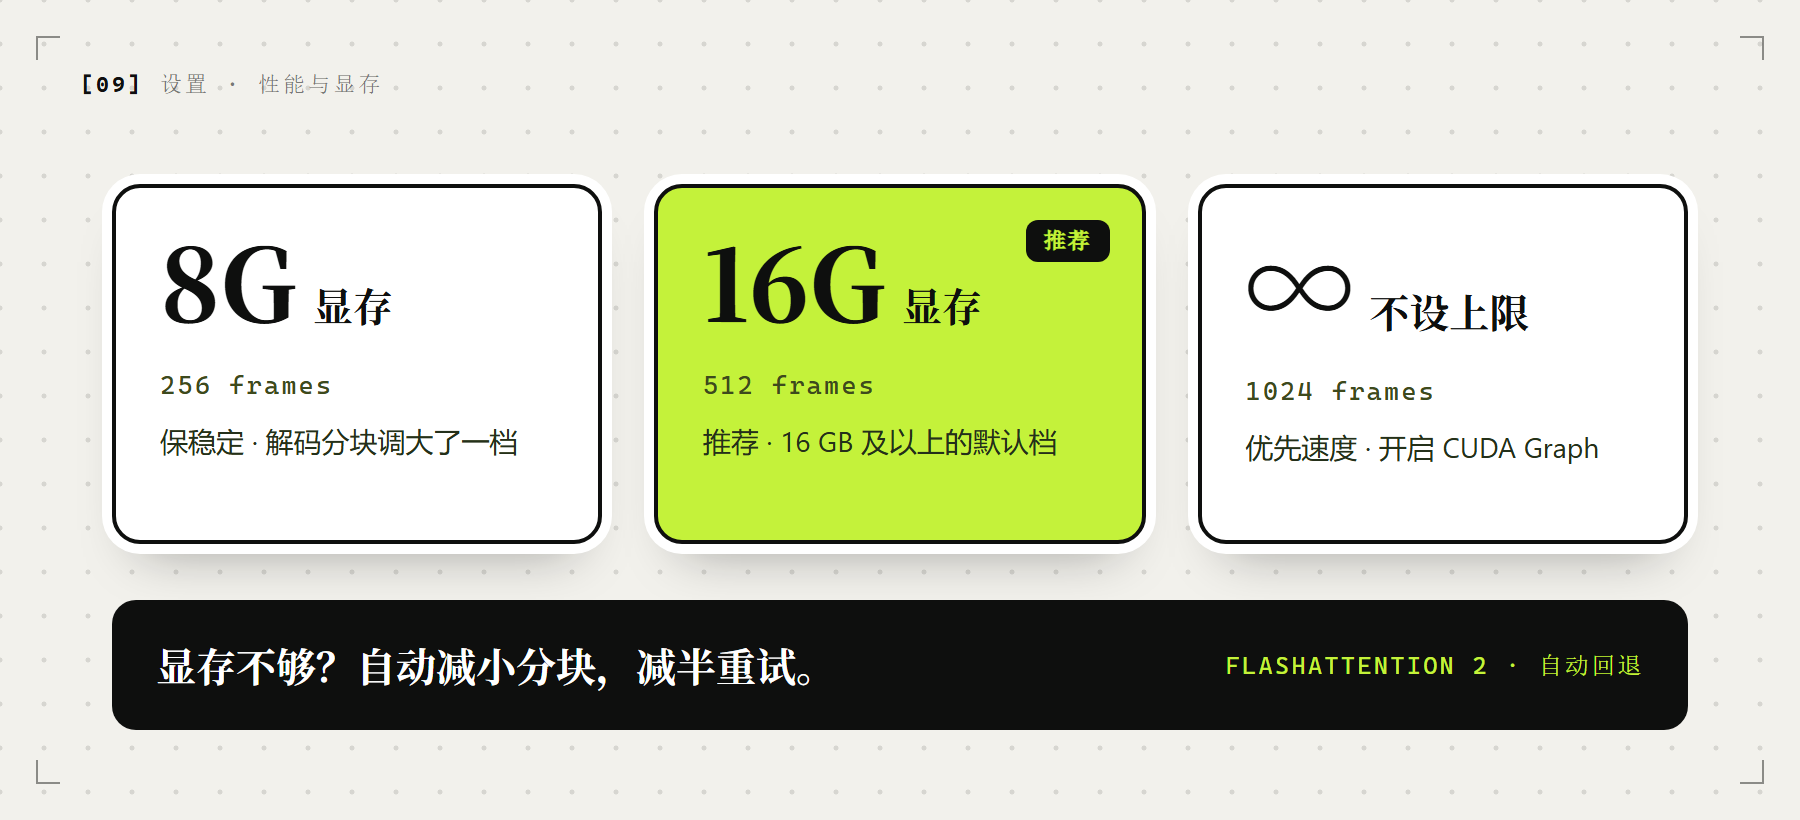
最低 8G 显存就能跑。8G 档的解码分块我也调大了一档;显存不够时,它会自动减半重试。
链接:https://pan.quark.cn/s/d6ff2a16d505
前端开源地址:【https://github.com/yamanacn/YUE2-workstation】
运行要求
:Windows 10 / 11 64 位 · NVIDIA 显卡,显存 8 GB 起 · 驱动 580 或更新 · 磁盘空间约 11 GB