报告长官,以下是AI动图的探路情况。ai动图视频逐步出现在大众视野,不过目前效果可能有点迷。由于个人接触有限,如果有大佬有新尝试,能补充更多内容,感激!
下面涉及的所有有关AI动图视频的软件和平台基本都需要稍微会写点描述词的能力,动图的制作和普通AI绘图极其相似,只是需要在关键词的内容上注意以下几个点:
①描述的角色的内容旁,增加动词动作,比如女孩微笑大笑
②描述风格的用词旁边,采用移动方向的描述,比如向左平移,向上向下
AI绘图里大致有midjourney还有stable diffusion两派,类比一下,AI动图和视频内容中,Runway和midjourney很类似,可以不用魔法,除了Runway应该还有很多不同的平台在,希望能有更多便宜大碗的网站推荐。
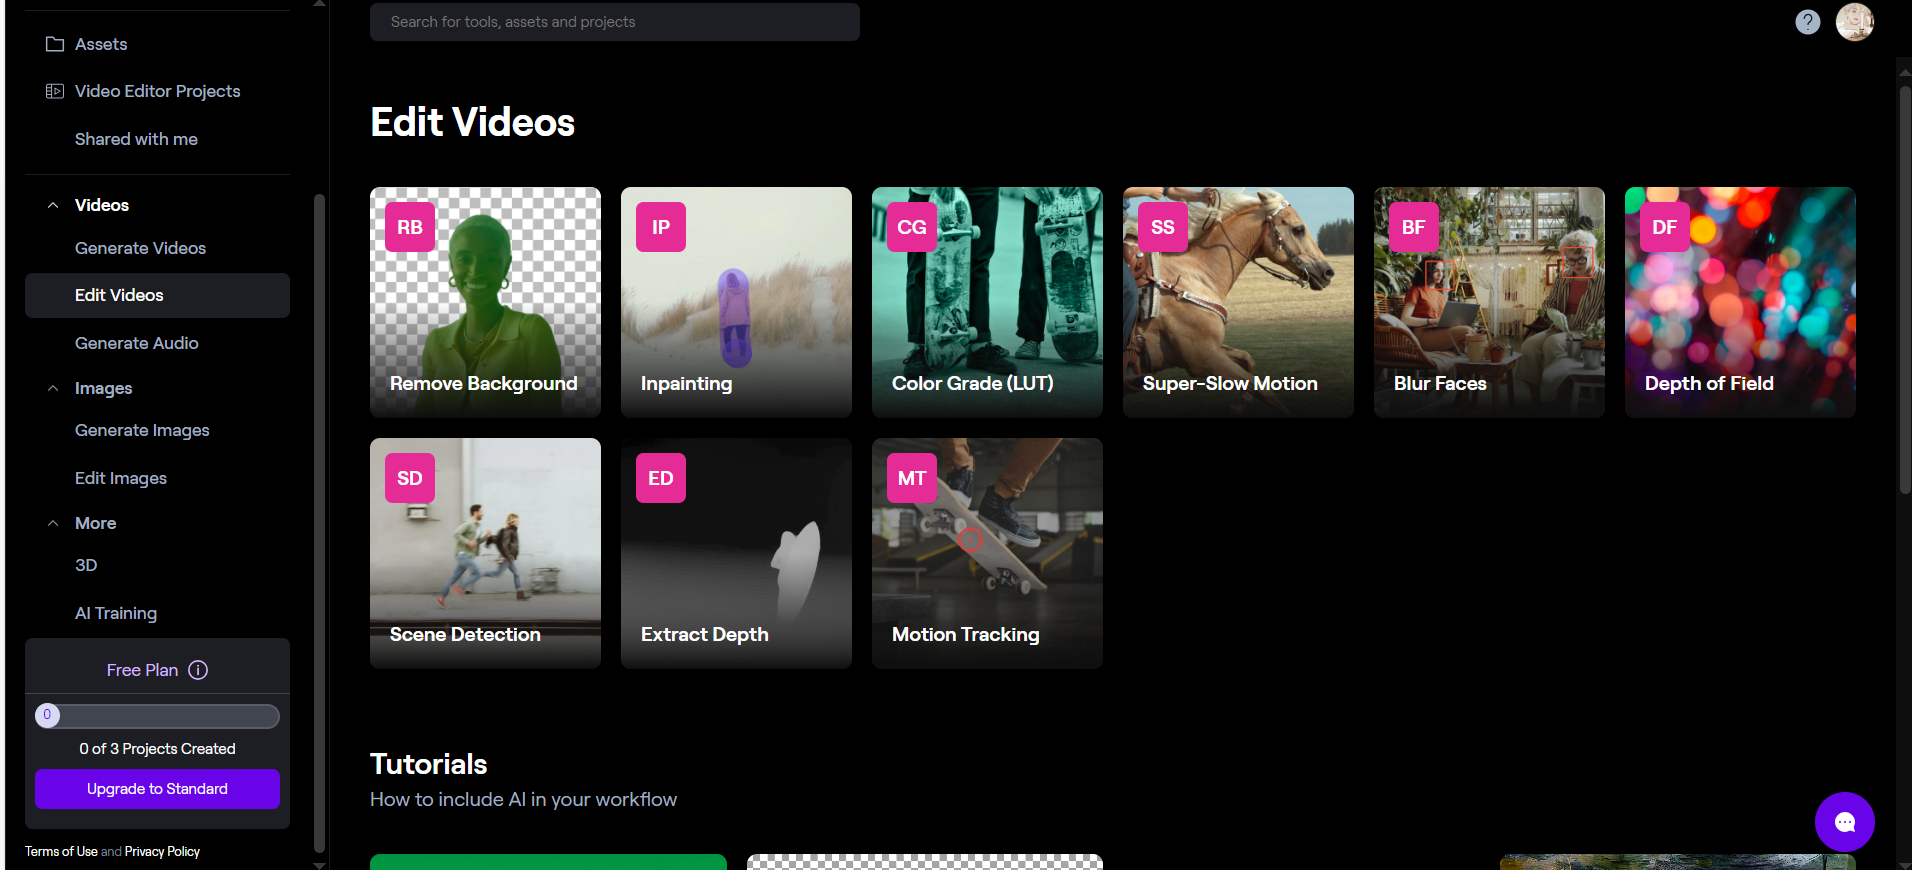
Runway官网可以直接生成视频:https://app.runwayml.com/
①绿幕去背、模糊人脸、移除影片物件等等视频剪辑的便捷操作,尝试一下会有惊喜。
②不吃自己的显卡,如果电脑配置跟不上,类似Runway的平台,真滴香。
③笔刷涂抹控制部分画面移动情况,这个设计补足了单单文字提示词的短板,更适合生成稳定的图片。
①目前没能找到以视频生成AI视频的操作,只有文字描述生成或者图片生成视频。
③每次生成的视频或者动图的时长只能4秒,但是由于可以在4秒的基础上,通过最后一帧生成再获得四秒钟,其实是可以拼成很长一段视频
很早的时候大多数AI视频的做法是运用stable diffusion中controlnet对已经变成图片的视频帧进行批量AI绘制,然后运用图片转视频的操作再形成AI视频,但是这种处理方式会出现跳帧以及不稳定现象。然而近期Animate diff终于出stable diffusion的插件了,效果比较丝滑、稳定、闪烁较小,是一大进步。
①可控性比Runway高,不卡死4s钟,显卡有多大胆,时间有多大产。
①需要不错显卡,推荐显存12GB往上(个人是N卡3060,12GB,用的SD WebUI版本的Animate diff,不太能视频生成视频很容易爆显存),当然也有说8G显存也够用。
①单独安装ComfyUI版的Animate diff,占用显存比较少,但需要适应新的工作流节点
②云端租用,可以尝试百度的飞桨平台每天可以免费用8小时,或者使用青椒云可以按小时租用云端电脑搞搞(只带了笔记本电脑的时候会用)
①SDwebUI扩展-可用-搜索animate diff安装插件即可
②animate diff模型和镜头运动lora下载:
模型放到SD源目录\extensions\sd-webui-animatediff\model
镜头控制lora放到SD源目录\models\Lora
①显卡配置不高,建议高度*宽度512*512分辨率生成,后期放大。
③动画模型:不同模型可能使用体验不同,目前尝试二次元模型要比三次出效果。
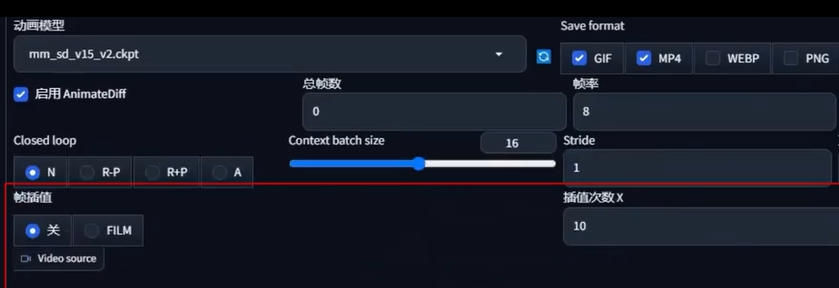
④总帧数不小于帧率,帧率默认填8比较好用,容易出效果。
⑤closed loop中N(不循环的视频动图)A(循环的)R-P、R+P(由算法按效果生成是否循环的动画)
普通提示词后加上Prompt Travel触发词“帧数: 提示词”,注意半角冒号后面有空格。
1boy,short black hair,smile,Masterpiece
说明刚开始是闭嘴,第8帧后张开嘴巴,从而使用提示词控制画面。
②添加控制镜头lora:此处不如Runway的画笔控制部分画面移动的功能好用,是对整个画面的镜头移动控制。
想要生成两张图间隔动画:可以controlnet上传初始图,animate diff上传末尾帧内容,中间由AI发挥,注意绘制中重回幅度尽量调整较大,不要太小,太小容易突变容易出怪东西,合适重绘幅度为0.75左右。
以上是简单的部分操作示意,有更多探索体验,欢迎交流!